我的 AI 工具链:四个模型怎么分工

一句话结论:我不追求「一个模型解决所有问题」。四个模型各管一段——Anima 负责二次元出图,Krea 2 负责补细节与超分,MiniMax-H3 负责视频,Qwen-Image 2.1 负责通用生成与工作流底座。它们全部跑在一台 8GB 显存的笔记本上。

为什么不用一个万能模型

刚开始我也想过,找一个最强的模型就够了。跑了几个月之后发现:通用能力和专项能力是两条不同的曲线。通用模型理解力强、什么都能画,但在某个具体风格上往往不如专项模型;专项模型把一种风格做到极致,换个场景就立刻失效。

与其在两者之间反复妥协,不如让每个模型只做它最擅长的那一段。

四段分工

模型 它负责的一段 为什么是它
Anima-2.9B 二次元出图 Danbooru 标签模型。颜色鲜亮、姿势大胆,能直接生成热门作品的角色,也能模仿画师的画风
Krea 2 细节补充与超分 通用模型里理解力最强的一档。用它做二次采样,能把画面的细节密度拉上去
MiniMax-H3 图生视频 / 参考生视频 把静态画面变成镜头,是本地产出动态内容的路径
Qwen-Image 2.1 通用生成与工作流底座 覆盖面宽,适合做兜底方案,也是改造其他社区工作流的起点
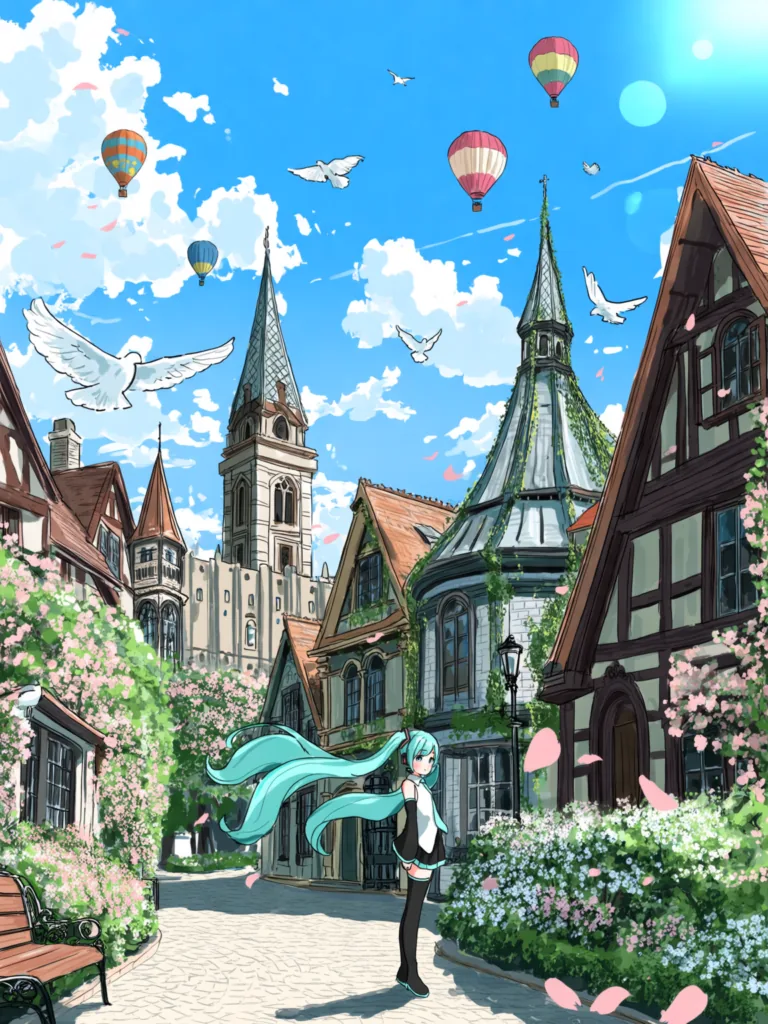
Anima 生成的初音未来立绘,欧式小镇街道场景
Anima 负责的这段:构图与角色先立住,细节留给后面的模型去补

它们怎么串起来

实际跑的时候,这四个模型不是并列关系,而是一条链:

  1. Anima 出草图。先快速跑出构图和角色。这一步不追求细节,追求的是方向对不对——方向错了,后面再怎么补都是白费。
  2. Krea 2 做二采。把选中的图送进 Krea 2 做二次采样补细节。前提是输入必须达到 2K,否则角色一致性会崩,甚至出现大量噪音。
  3. 超分收尾。用 4x-AnimeSharp 把画风拉回 Anima,再用 Lanczos 把输出控制在可用尺寸——不加这一步,产出的图会大到不好用。
  4. 需要动起来就交给 H3。把成图作为首帧或参考帧,接进 MiniMax-H3 的工作流出视频。

8GB 显存意味着什么

整条链路跑在 RTX 5060 Laptop / 8GB 显存 / 16GB 内存的配置上。8GB 是个很硬的约束,所有模型都必须在量化版本和显存优化之间做选择,工作流也要逐条按显存重新调。

但这不等于「跑不了大模型」。视频侧最重的一次,我把 47GB 的权重放进了 8GB 显存里跑通——靠的是量化、分块加载和节点级的显存优化,而不是更大的显存。

为什么坚持本地跑

不是为了省钱。只有自己从头跑通一遍,才知道每一步的取舍在哪里:哪一步吃显存、哪一步是瓶颈、哪一步能用更省的方案替代。这些看教程看不出来。

下一步

每一段我都单独写过。Anima 的完整入门在《新手看了就会用的 Anima 教程》,进阶玩法(Lora、超分、Krea 2 二采)在《Anima 进阶》;整套工作流的清单整理在《我的 ComfyUI 工作流资产》。
Anima进阶——Lora,超分与Krea2二采

一句话结论:想让 Anima 的出图从“能看”到“耐看”,靠的是三件事——用 Lora 补上模型不认识的角色,用超分把图放大,再用 Krea 2 二采把细节密度拉满。最后一步是我自己做的工作流。

先补上模型不懂的部分:Lora

想必你也看过那些用 Anima 生成的超级精美的图片吧——不仅细节更多,而且还有 2K、4K 的尺寸。这里主要用到的,就是 Lora 和超分的技巧。

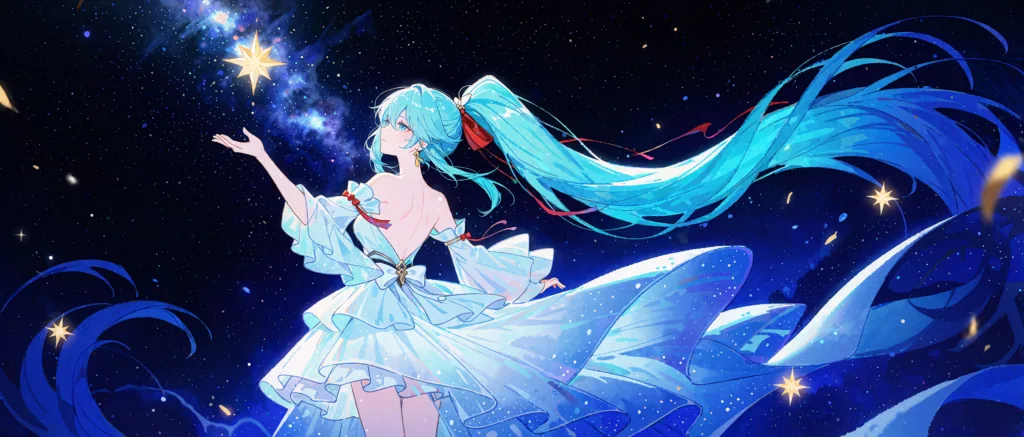
Lora 加超分之后的成图:初音未来立于星空之下,向发光的星辰伸手,白色礼服
Lora + 超分之后的成品:这个尺寸下的细节密度,是直出给不了的

Lora 主要是弥补模型所不了解的部分,比如画风、人物、服装、姿势等等,相当于让模型重新学习一个内容。画风 Lora 可以在 Civitai 上面下载,因为画风仁者见仁智者见智,所以我不做推荐。

从零训练一个自己的 Lora

如果你要跑的角色比较新或者比较冷门、Anima 完全不认识,或者是你的 OC,就可以通过 Lora 让模型学习。这里以我自己训练的卡拉彼丘角色米雪儿为例,这个角色比较冷门。

  1. 搜集素材。为了让模型能够充分学习,至少准备 20 张高质量训练图,越多越好。图片要主体清晰、没有干扰项,并且覆盖角色在不同场景下的状态——正面侧面、站起坐下、喜怒哀乐。为了保证学习时不被干扰,图片尽可能画风一致或接近,角色特征鲜明。
  2. 打标。通常使用 WD14 模型。为了保证质量,模型处理完之后还要人工检查一遍。打标涉及触发词和学习词:触发词是训练好之后调用 Lora 时要输入的词,因此要放在首位;学习词比较反直觉——如果你希望模型学到什么,就要把它删掉。训练时模型会把学习词 tag 与图片内容一一对应,最后学到的是剩下的部分。
  3. 训练。训练 Lora 比较吃配置,一般租用云端来跑,一个 Lora 大约 5–10 元。不同训练器的用法不一样,跟着各自教程走即可,没有统一的训练方法。
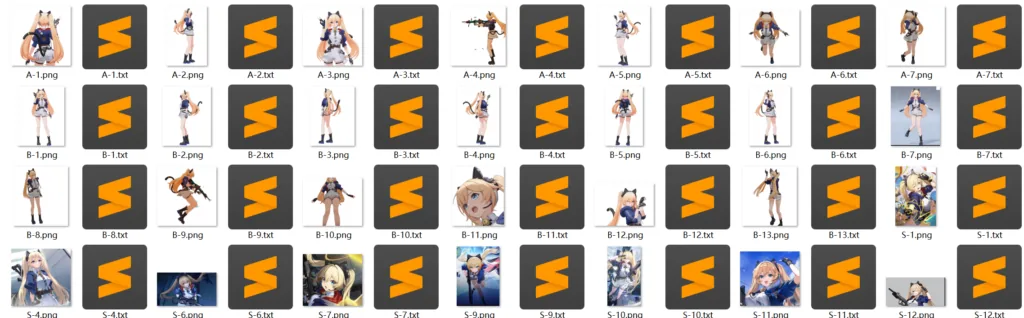
打标后的 LoRA 训练集文件列表:每张图片配一个同名 txt 标签文件
打标后的训练集:图片与同名 .txt 标签文件成对出现
省力技巧

打标这一步可以借用有视觉能力的大模型来帮忙,比如 DeepSeek V4.1,效果很好。

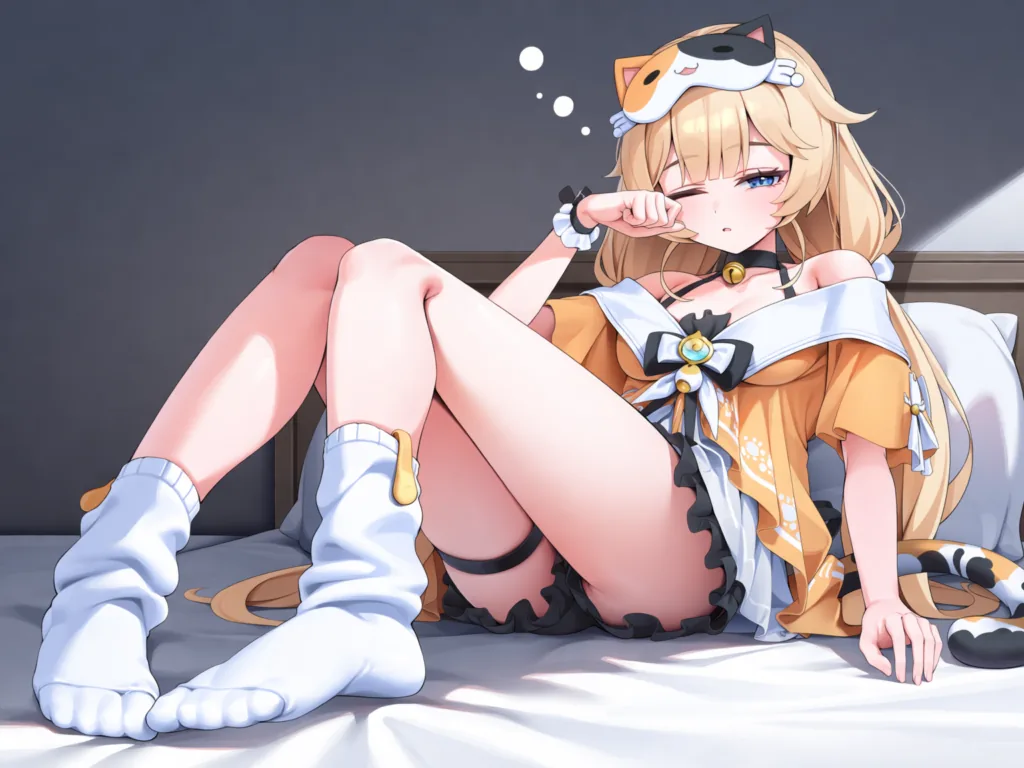
自训 Lora 生成的米雪儿,猫主题服装,坐在床上
自训 Lora 效果 · 一
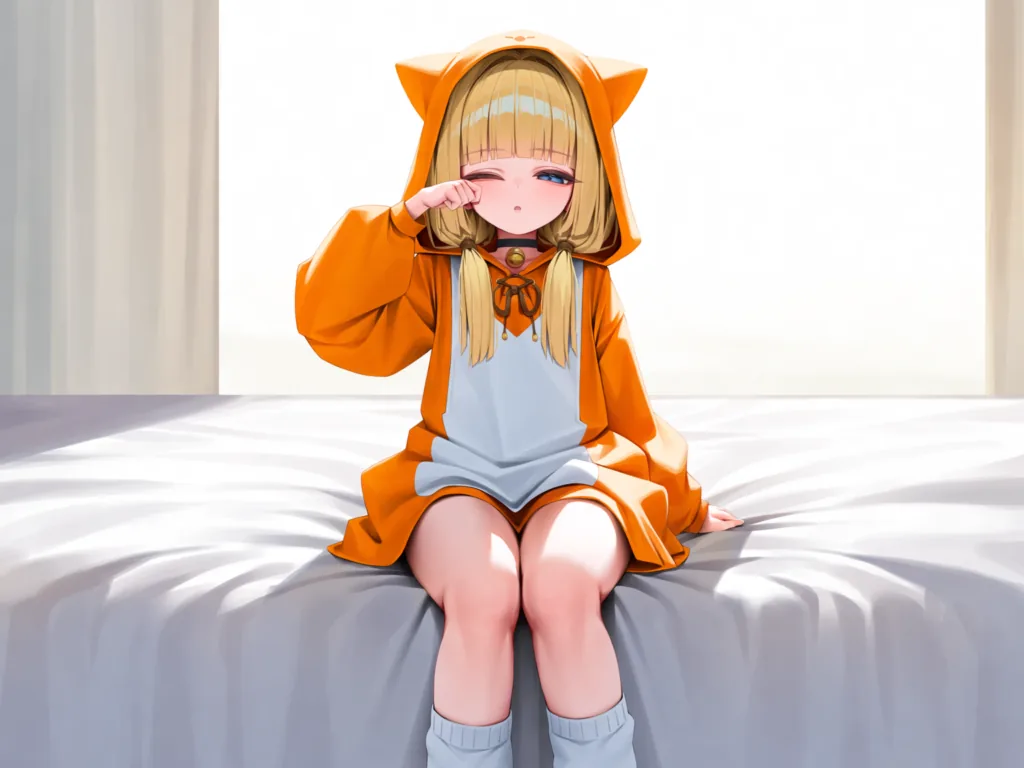
自训 Lora 生成的米雪儿,橙色连帽卫衣,坐在床上揉眼睛
自训 Lora 效果 · 二

超分:把图放大,还要更好看

超分也就是在保持原有质量的同时放大图片,本质是重绘。从易到难,有三条路线。

方案 做法 代价
Lanczos 放大 ComfyUI 自带节点,可实现任意倍数放大 最省事,至于效果嘛……
超分模型 用 4x-AnimeSharp 这类超分模型做 4 倍放大 保持原有质量,甚至进一步优化细节
二次采样放大 不同模型接力,各取所长 效果最好,但要自己搭工作流

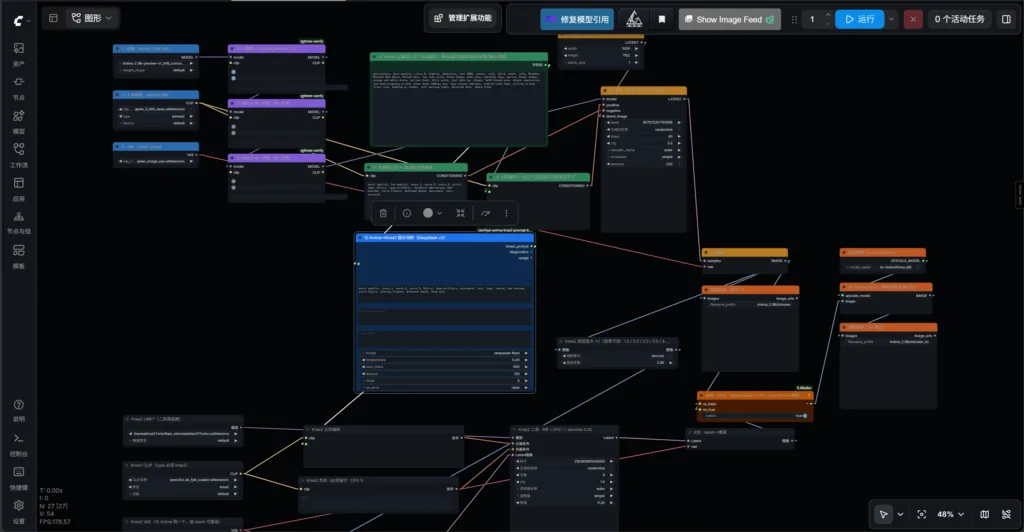
Krea 2 二采:我的原创工作流

先说 Krea 2。它是目前开源社区最强大的通用模型,理解能力强、生成画面质量高、多场景适配。但它本身不是专门生成二次元的,所以直出的二次元图片比较单薄,也认不出画师和人物——需要配合社区调整过的模型,或者用画风 Lora 来约束。

拿它来做二采,就是希望借助它来丰富细节、提高画面质量。

Krea 2 二采超分工作流的 ComfyUI 节点全景图
Krea 2 二采工作流全貌

这是我对这个工作流的完整讲解,里面有工作流和模型下载链接:B 站 · Anima + Krea 2 二采超分工作流。

两个必须注意的点

  1. Krea 2 二采对输入图片有要求,最低 2K,否则无法保持角色一致性,甚至可能出现大量噪音——这和 Krea 2 训练时学习的图片尺寸有关。
  2. 二采出来之后,还有一个 4xAnimeSharp 放大的步骤,这是让画风回归 Anima 的步骤,但会让产出的图片非常大,可以在中间用 Lanczos 缩小。
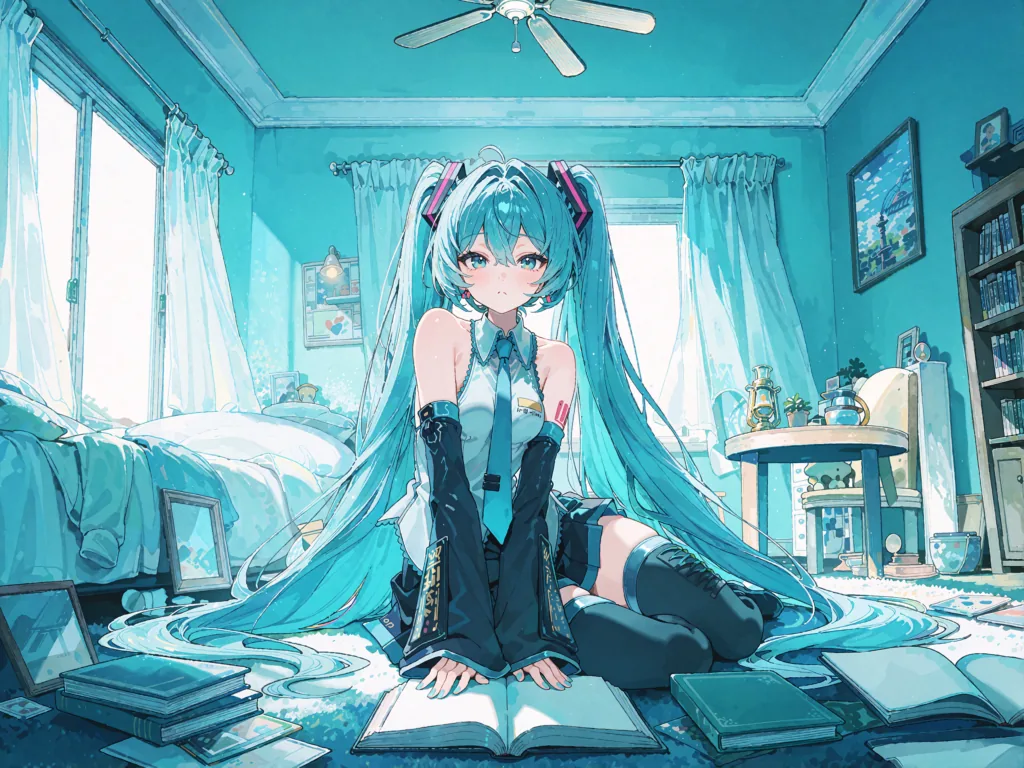
二采加超分后的成图:初音未来坐在蓝色房间地板上,面前摊开一本书,周围散落书本与相框
二采 + 超分后的成图:书本、窗帘、地板纹理的细节明显更密
还没入门?

如果连模型文件和提示词都还没搞明白,先看《新手看了就会用的 Anima 教程》——把基础流程跑通,再回来做进阶。

新手看了就会用的Anima教程

一句话结论:Anima 是专门为二次元训练的模型——颜色鲜亮、姿势大胆,能直接生成热门作品的角色,也能模仿热门画师的画风。看完这一页,你就能把 Anima_2.9b 从零跑通:模型备齐、提示词写对、参数调对。

Anima 是什么

Anima 是一个专门为二次元图片训练的模型。颜色鲜亮,人物姿势大胆,能够直接生成热门作品角色的图片,也能模仿热门画师的画风。Anima 有很多版本,不同版本的效果略有不同。截至写这篇教程时,Anima 最新版本为 Anima_2.9b,也是本文示范所用的模型。

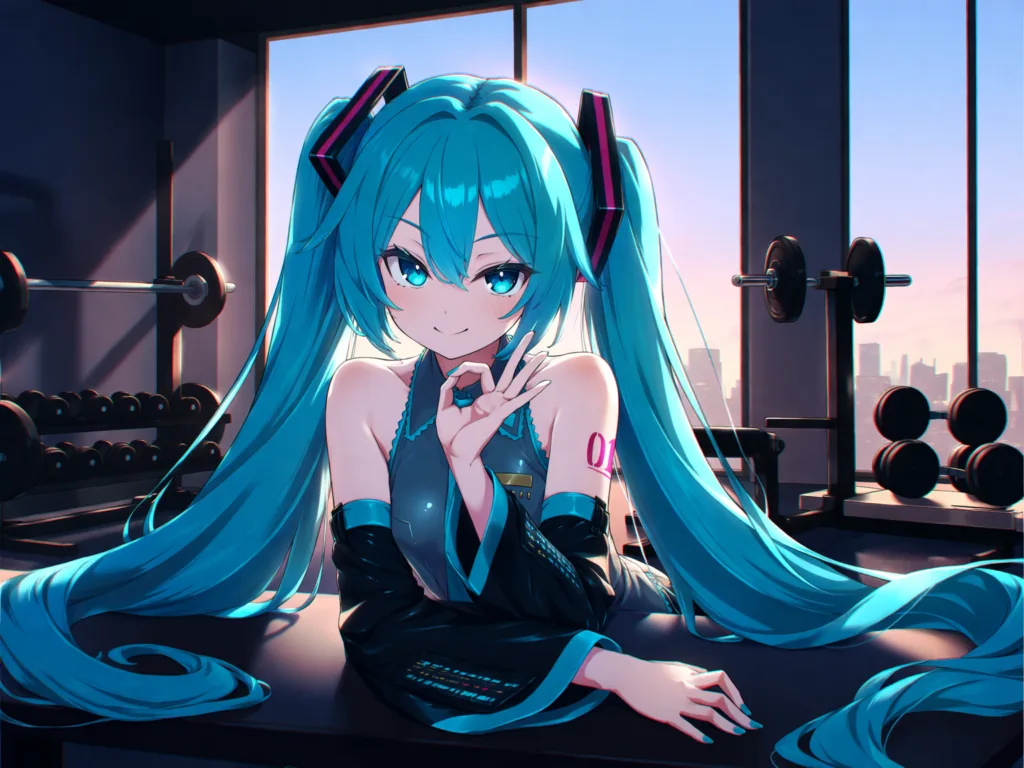
Anima 2.9b 生成的初音未来,健身房场景,蓝绿色双马尾,落地窗外是城市天际线
Anima_2.9b 直出:健身房里的初音未来,光影和发丝已经不需要再修

开始之前:备齐三件套

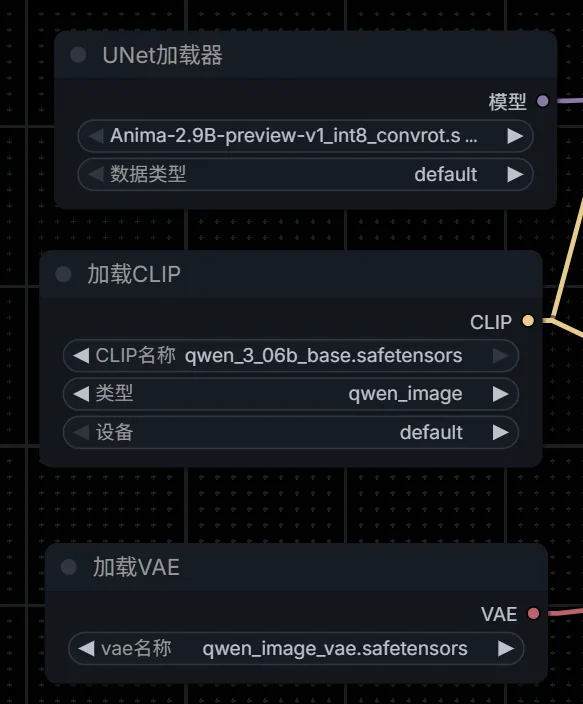
Anima_2.9b 在工作流里主要由三个节点搭配,qwen 确实在开源上有巨大贡献。

节点 文件 作用
UNet 加载器 Anima-2.9B-preview-v1_int8_convrot.safetensors 主模型,决定画风与画面内容
加载 CLIP qwen_3_06b_base.safetensors(类型 qwen_image) 文本编码器,把提示词翻译成模型能读的条件
加载 VAE qwen_image_vae.safetensors 把潜空间结果解码成图片
ComfyUI 中的 Anima 三件套节点:UNet 加载器、加载 CLIP、加载 VAE
ComfyUI 里的三件套节点,从上到下依次是 UNet、CLIP、VAE

提示词:Anima 认标签,不认句子

关于提示词,Anima 是 Danbooru 标签模型——它的提示词不是“描述”,而是标签检索。理解这一点,下面三条铁律就都好懂了。

三条铁律

  1. 正面词与负面词会打架。同一个概念不能一边要一边挡(例:正面要 long neck、负面又挡 long neck)——模型会摆烂,画出“没有脖子”这种崩坏结果。
  2. 写标签,不写句子。1girl, solo, silver hair 有效;a girl with silver hair standing on a beach 会被稀释成噪声。
  3. 标签之间有互斥与竞争。姿态、镜头、取景三组标签会互相推翻——改需求时必须删掉旧的那一组,光加新词是改不动的。

用 Agent 帮你写提示词

为了方便生成提示词,可以把 Anima 提示词专家的 prompt 交给 Agent,或者直接调用对应的 skill。在后续的出图调整里,不断让 Agent 回顾你的个人要求、对提示词持续迭代,最后就能形成一份带有你个人色彩的提示词专家。

Anima 生成的初音未来立绘,欧式小镇街道场景,蓝天与热气球
用 Agent 反复迭代出来的提示词产出的成品图

以后的模型大概率都会支持自然语言处理,Danbooru 标签大概会成为 Stable Diffusion 刚刚兴起时,学习者们的一段回忆吧。

参数:真正要管的只有三个

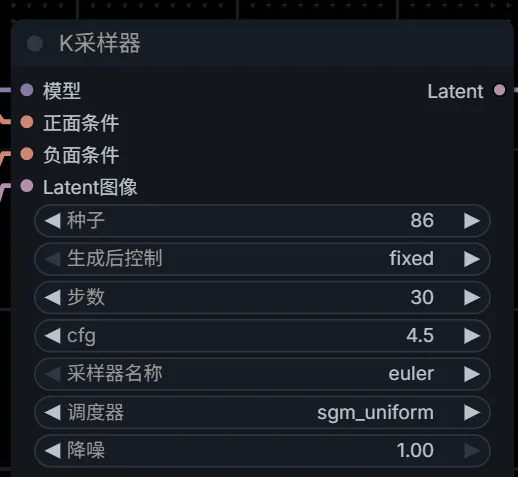
接下来是主要参数的调整,也就是 K 采样器。它决定模型如何从一张噪点图走到成品,而其中真正需要你判断的,只有三个参数。

K 采样器节点参数:种子 86、生成后控制 fixed、步数 30、CFG 4.5、采样器 euler、调度器 sgm_uniform、降噪 1.00
本文实测参数:步数 30、CFG 4.5、euler + sgm_uniform、降噪 1.00

种子

种子决定随机效果。AI 生图首先给出一张噪点图,然后模型结合提示词和参数,从噪点图上“发动俺寻思之力”,最后“画”出图片——其实和你小时候盯着瓷砖花纹、想象它像什么是一样的。种子决定这块瓷砖的花纹,相同种子可以复刻相同效果。

步数

步数决定图片的精致程度:每多一步,模型就能多思考一层,给出更多细节。但步数过多会出现过拟合,图片效果反而下降。一般来说,追求速度可以设为 20,追求质量可以设为 40,这个范围之外效果会很差。

降噪

降噪决定图片的改变程度。文生图设置为 1 即可;图生图时,降噪越大,生成的图片越不像原图。

速查

种子决定可复刻性,步数决定精细度,降噪决定改变幅度——其余参数保持默认即可。

下一步

把上面这些学会,你就已经能够用 Anima 生成图片了。想让出图再上一个台阶——2K / 4K 超分、自训 Lora 复刻冷门角色、Krea 2 二采补细节——接着看进阶篇:《Anima 进阶:Lora、超分与 Krea 2 二采》。