我的 ComfyUI 工作流资产:2 条自建 + 8 条落地
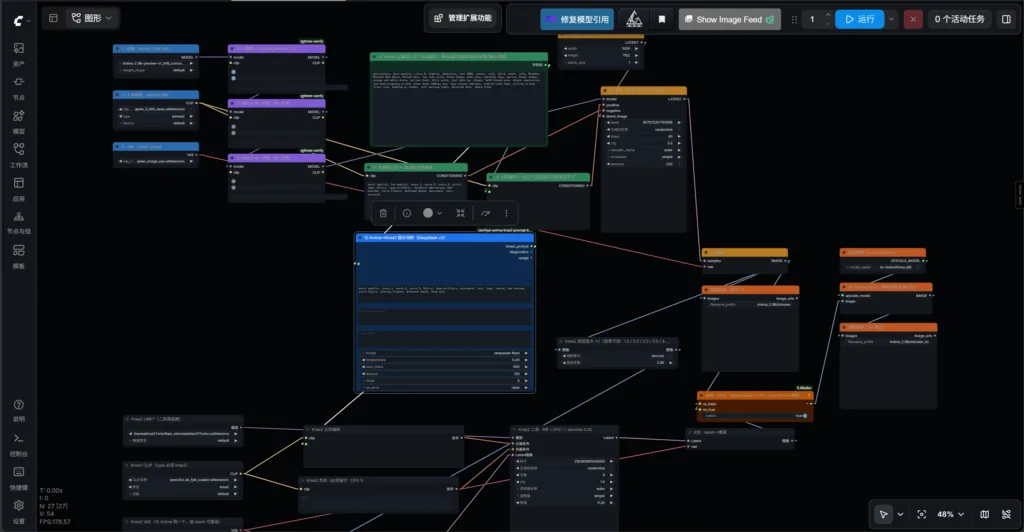
2 条自建 + 8 条从社区学到并本地跑通的工作流,逐条说明它们各自解决什么问题。共同前提:单卡 8GB 显存也能完整跑完。
一句话结论:我在 ComfyUI 里长期保留了 10 条工作流——2 条自建、8 条从社区学到并本地跑通。它们的共同前提是:单张 8GB 显存的显卡,也能完整跑完一遍。
先看整体
下面这条是我使用频率最高的工作流。前半段负责出图,后半段负责接力放大。节点多起来之后,「哪一段慢、哪一段吃显存」就变成了主要工作——这也是我后来把清单单独整理出来的原因。
自建的两条
Anima_2.9B 自由提示词 + Krea 2 二采(2K 版)
把 Anima 的自由提示词出图与 Krea 2 二次采样串在一起,输出稳定在 2K。这是日常出图的主力工作流。
Anima2.9B_自由提示词_Krea2二采_2K版.json
Anima_2.9B 布局 + Krea 2 二采超分(8 倍放大)
在 2K 版的基础上继续接超分。实际有两条放大路径——一条走 DeepSeek 桥,一条用 Lanczos 控制倍率。两者输出尺寸不同,用途也不同。
Anima2.9B_Yuri布局_Krea2二采超分版-DeepSeek桥-8倍放大版.json
Anima2.9B_Yuri布局_Krea2二采超分版-DeepSeek桥-lanczos倍率版.json
落地的八条
下面这些来自社区,我在本地做了适配与验证后才保留下来。
| # | 工作流 | 解决什么问题 |
|---|---|---|
| 1 | Yuri 布局 | 把 AnimaTools 的 LoRA 面板整理进一套顺手的出图布局,常用控制项集中在一屏之内 |
| 2 | 人脸精修(FaceRefine) | 批量出图时脸部容易崩,单独走一次人脸修复再收尾 |
| 3 | 双节点加速 | 视频工作流太慢,用双节点把采样时间压下来 |
| 4 | Director 导演台 | 参考生视频(r2v):画面构图与镜头交由参考图决定 |
| 5 | 潜空间放大(8GB 优化) | 二次采样放大时显存吃紧,改用潜空间放大配合 KJ 节点做显存优化 |
| 6 | 枫青衡多人动作迁移 | 把参考视频里的动作迁移到多人画面上 |
| 7 | MiniMax-H3 潜空间放大(一采预览锁种版) | 一次采样即可预览效果,锁定种子后重复出片 |
| 8 | Qwen-Image 2.1 基础工作流合集 | 通用生成的兜底方案,也是改造其他工作流的底座 |
关于「跑通」的标准
我的标准不是「节点能加载」,而是能在 8GB 显存下完整跑完一遍并稳定产出。显存不够的工作流,就算节点全绿也没有意义。
从这套工作流里学到的三件事
- 先看显存,再看速度。报错往往不是节点问题,而是某一步的中间张量超了显存。定位方法是从末端往前截断,找出第一次报错的位置。
- 加速方案要成组用。单纯换采样器收益有限;加速 LoRA、加速采样器和节点级优化配在一起,才把视频工作流的采样步数压到 4 步。
- 工作流一定要留备份。改坏一条工作流只要几秒,重建一条要几小时——所以我的工作流目录里始终留着带日期的备份副本。
工作流拆解
出图段:Anima_2.9B 自由提示词 → Krea 2 二次采样
超分段:4x-AnimeSharp 回归 Anima 画风 → Lanczos 控制输出尺寸
视频段:MiniMax-H3 Director(r2v / Fl2v)+ 双节点加速
显存策略:潜空间放大 + KJ 节点优化,避免二次采样阶段爆显存
超分段:4x-AnimeSharp 回归 Anima 画风 → Lanczos 控制输出尺寸
视频段:MiniMax-H3 Director(r2v / Fl2v)+ 双节点加速
显存策略:潜空间放大 + KJ 节点优化,避免二次采样阶段爆显存
参数表
- 显存约束
- 8GB(RTX 5060 Laptop)
- 视频加速
- 加速 LoRA + lightx2v turbo
- 视频采样步数
- 4
- 采样器
- euler
- 二采输入下限
- 2K(低于此值角色一致性会崩)