Qwen-Image 2.1 本地实测:8 GB 显存 18 秒一张,中文零错字
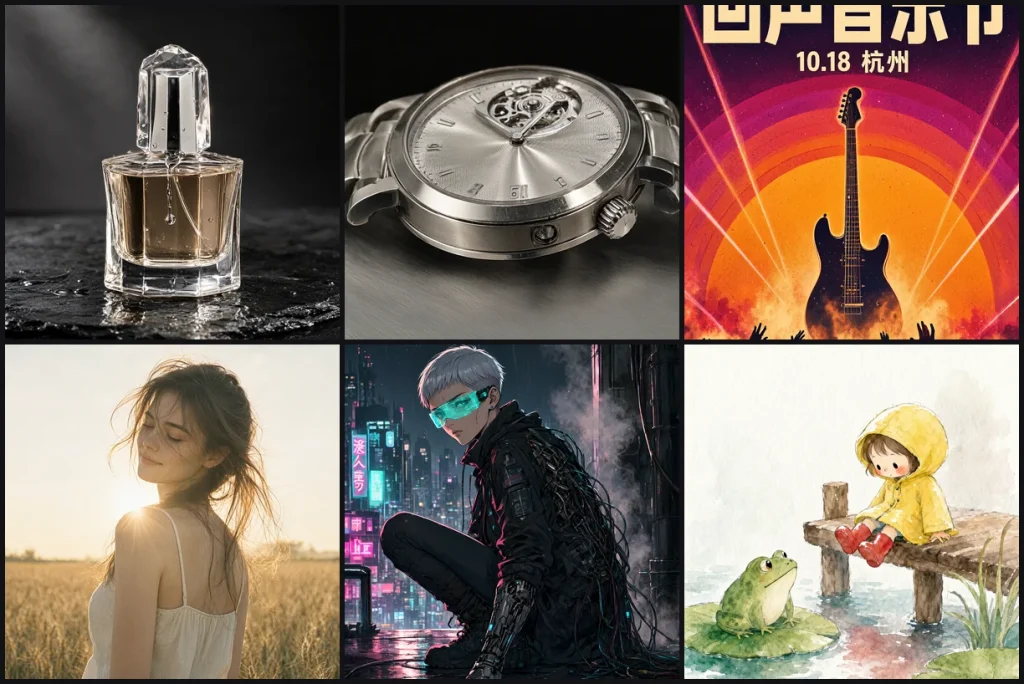
一句话结论:在一台 8 GB 显存的笔记本上,把 Qwen-Image 2.1 压到单张 18 秒,并产出 32 张可以直接用作作品集的成品——覆盖电商产品、海报设计、真人写实、二次元插画与图像编辑五类,13 处中文字串全部零错字。但速度不是白拿的:这篇把配置、参数、逐张耗时和五个坑全部摊开。
先看结果
32 张成品在同一天内跑完,封面那张拼贴就是从里面挑的六张代表作——切面水晶香水瓶、不锈钢机械腕表、复古未来音乐节海报、麦田逆光人像、赛博朋克动漫、水彩绘本。下面每一张都标了尺寸、随机种子与实际耗时——数字来自批量管线的逐张记录,不是估的。
共同前提(后文不再重复):6 步采样、关闭 CFG、LoRA 强度 1.0,提示词全部人工撰写,未启用官方的提示词增强器。
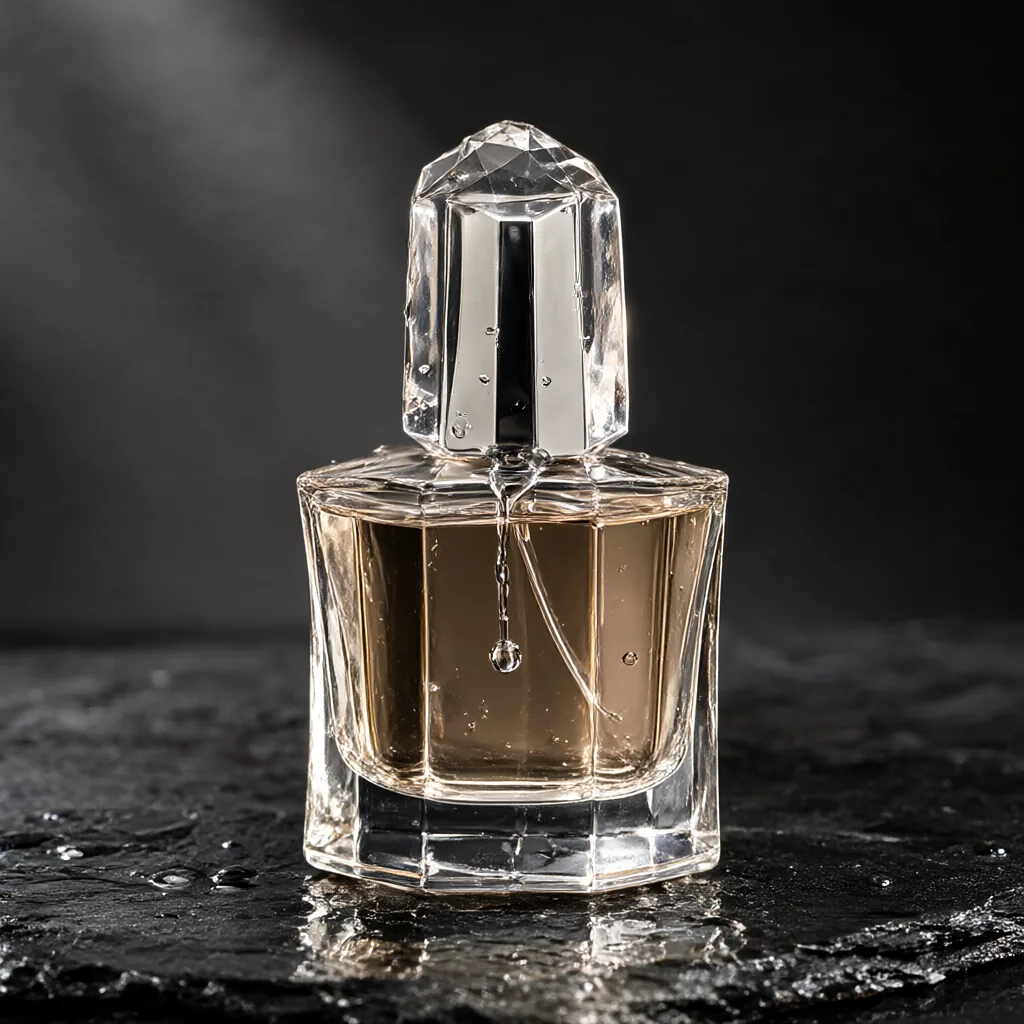
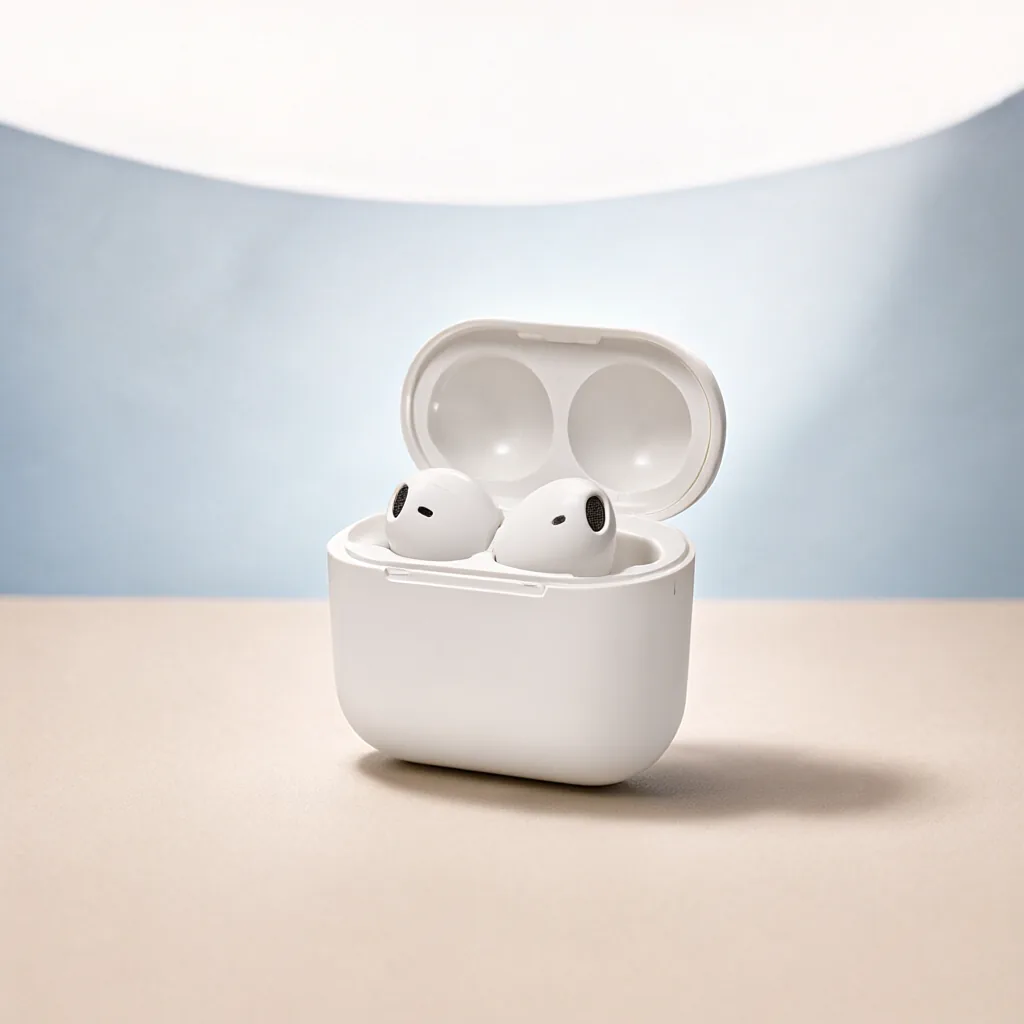
A · 电商产品(1024×1024)
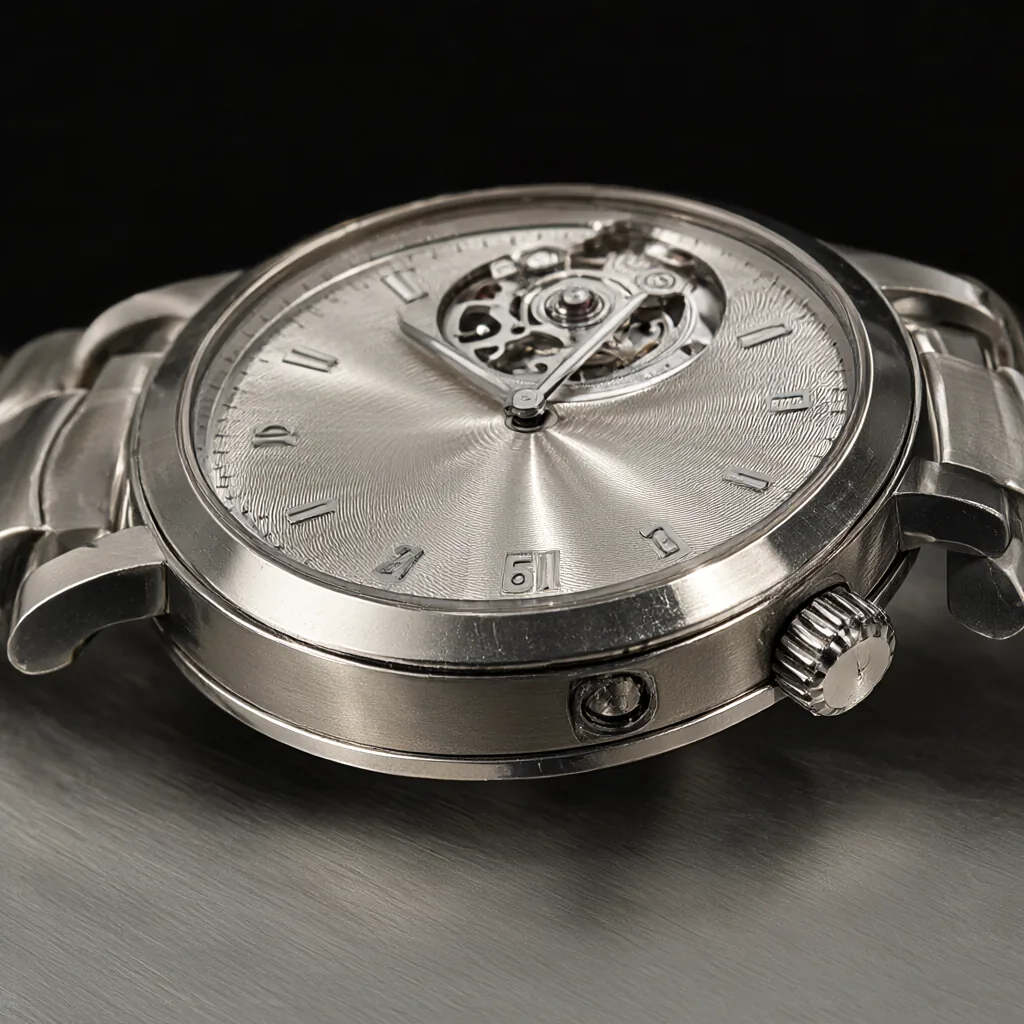
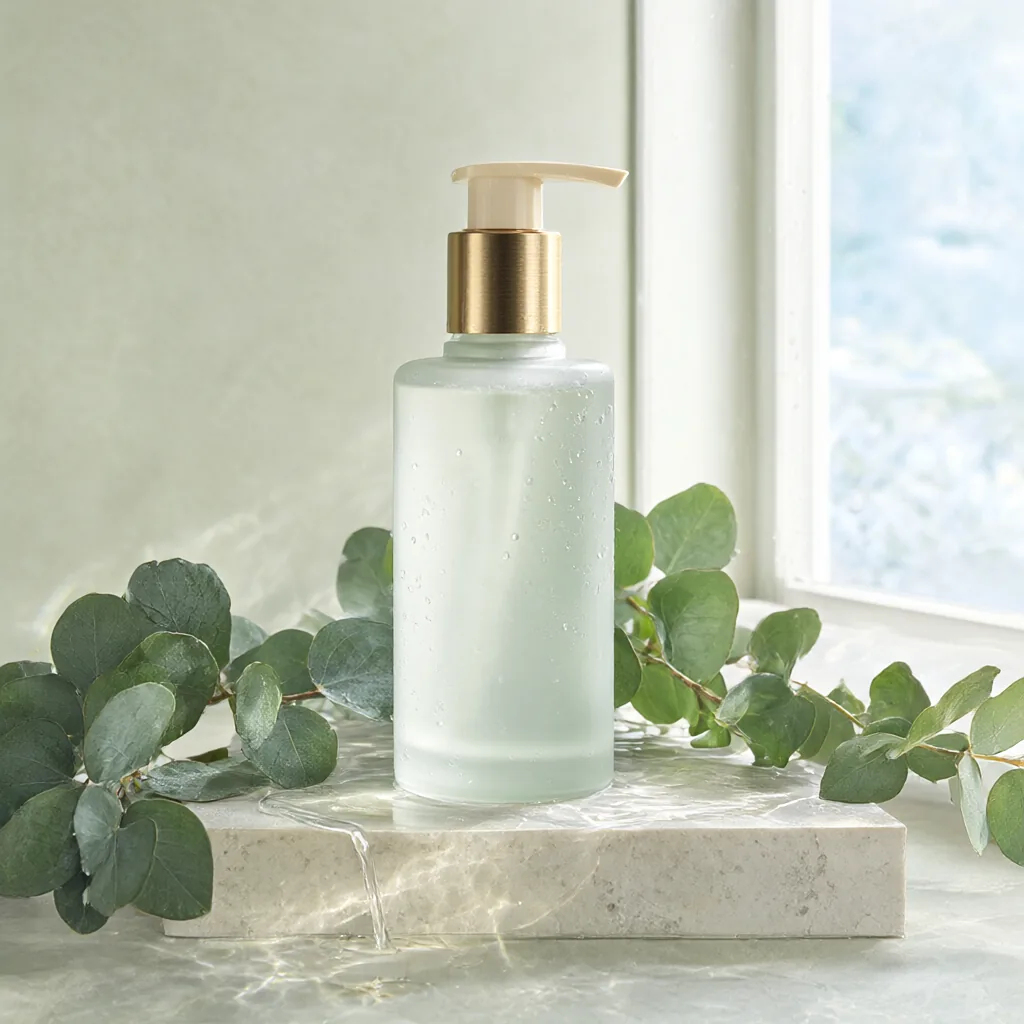
B · 海报设计(896×1216)
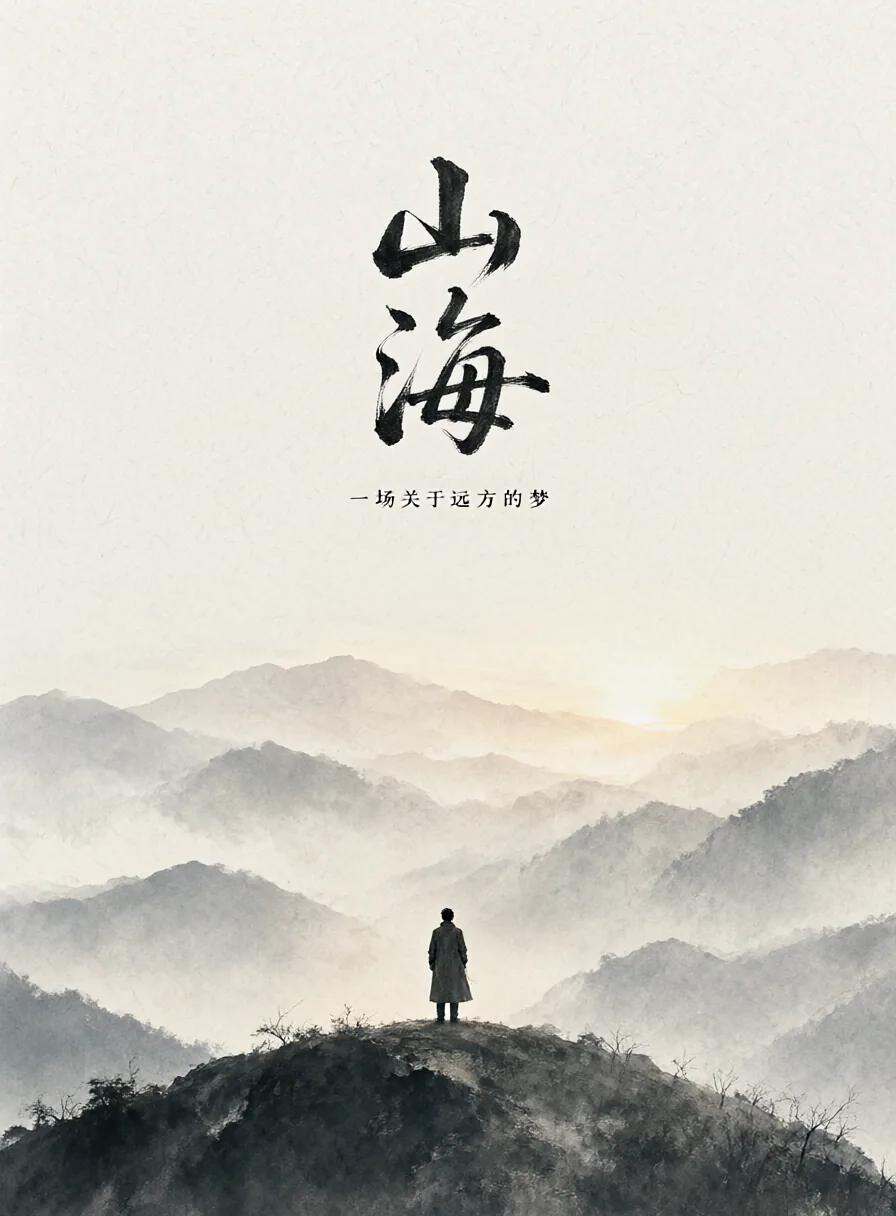
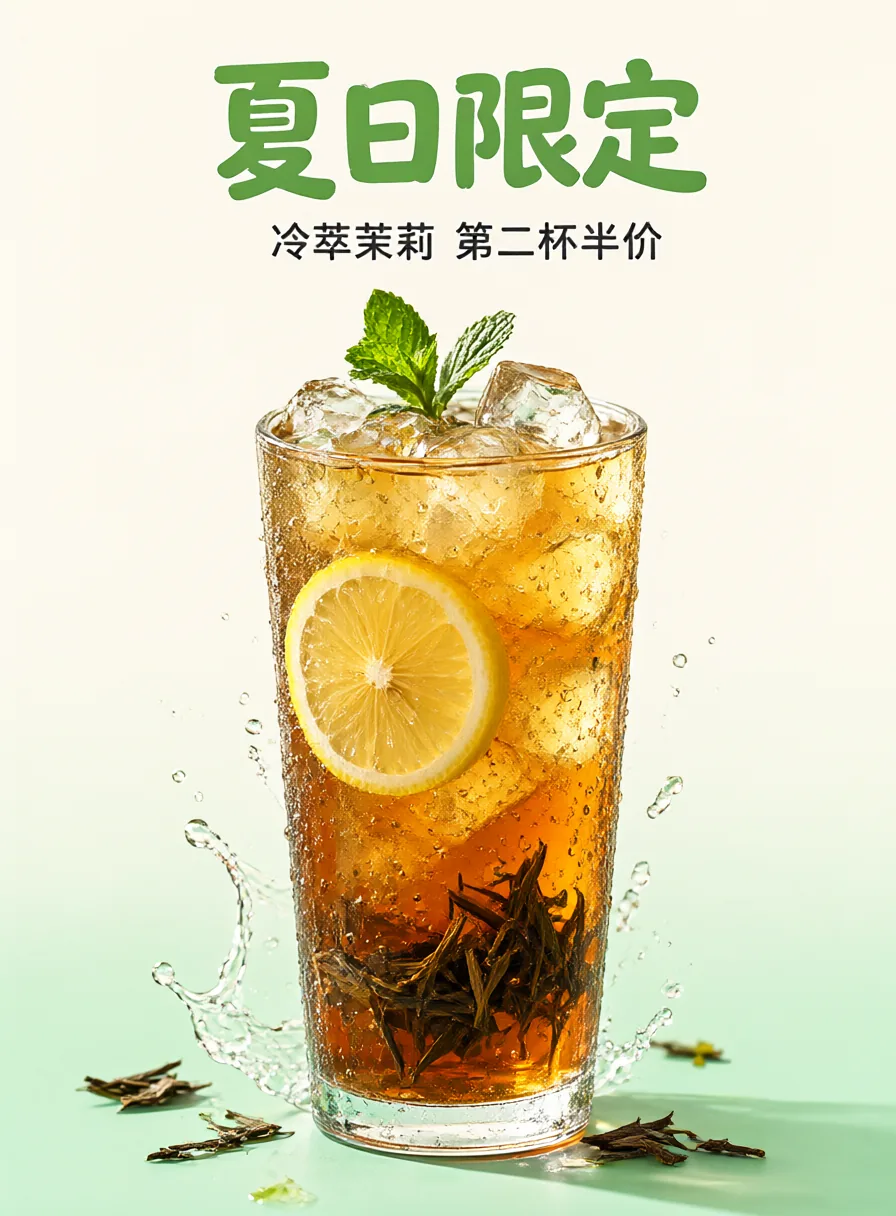
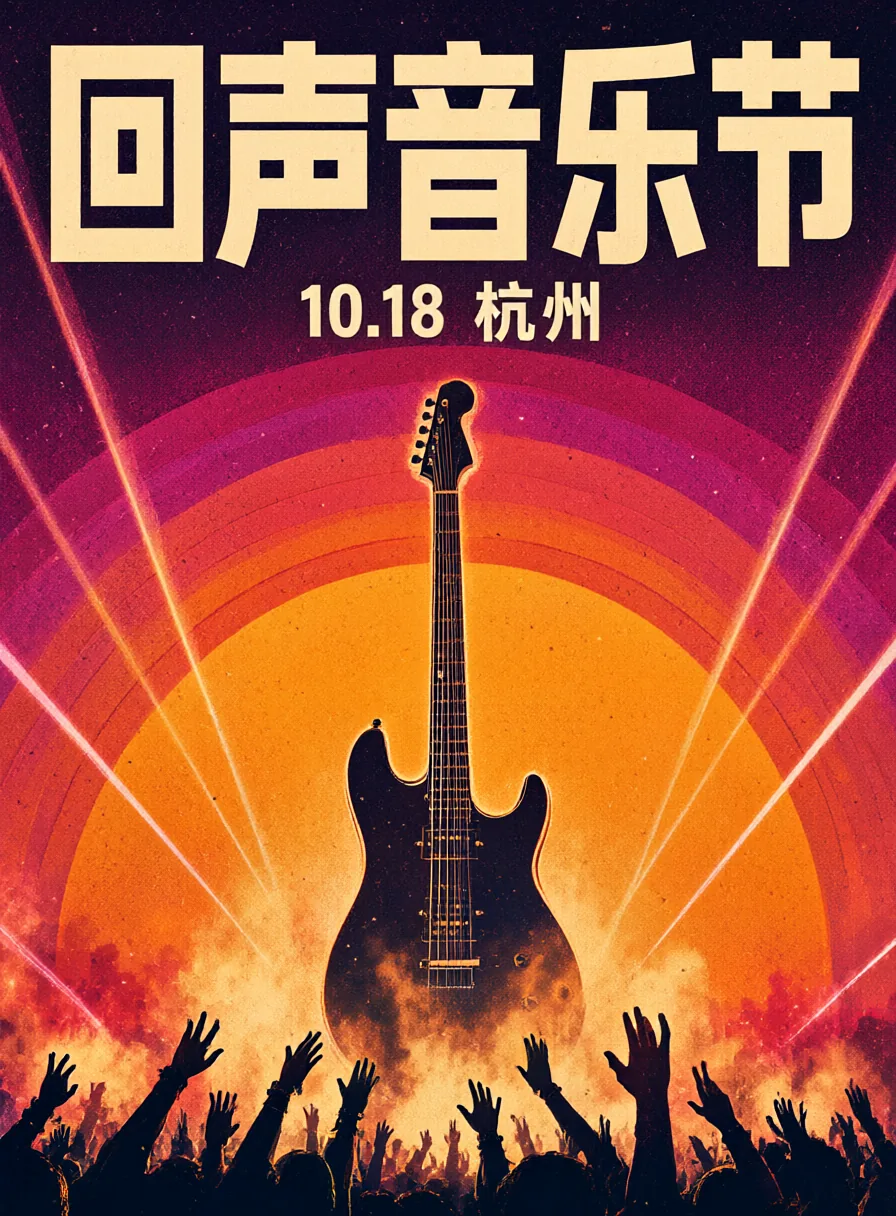
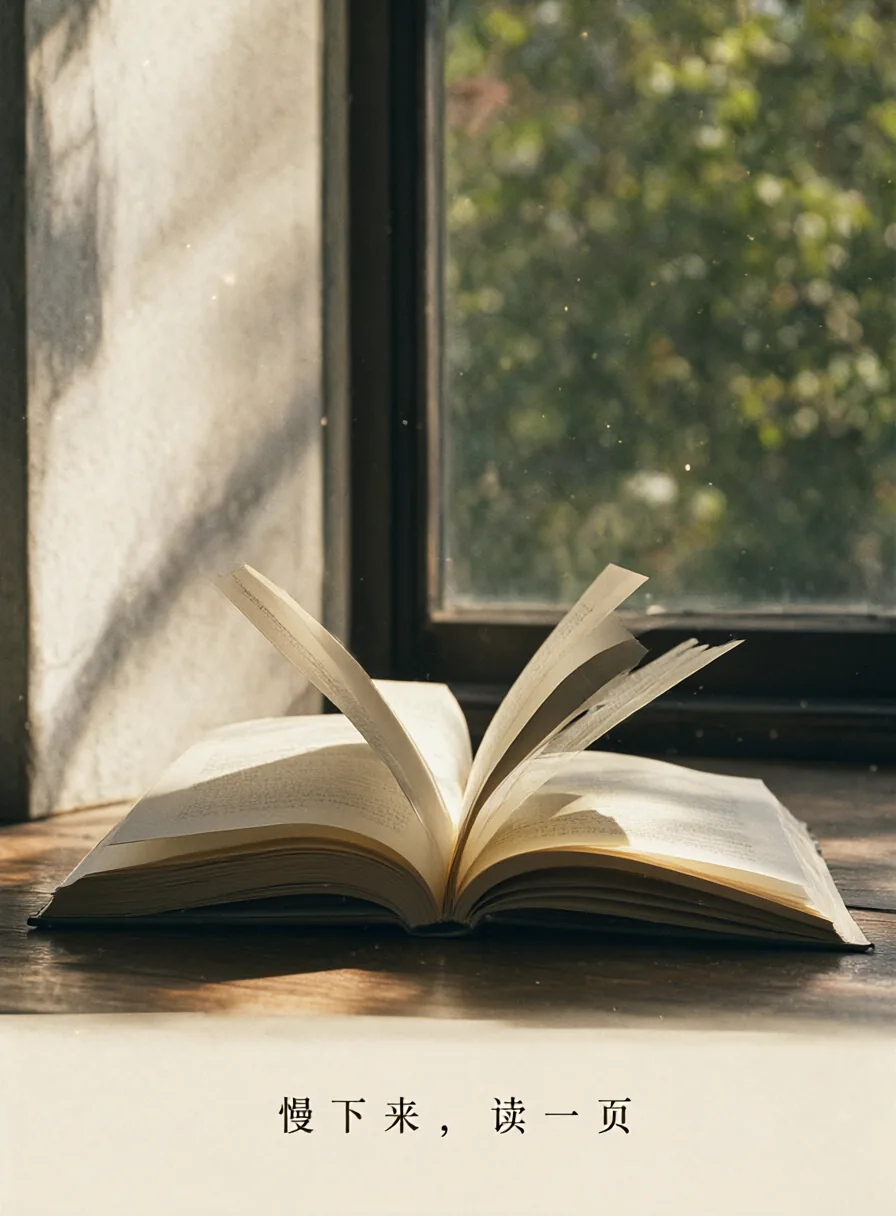
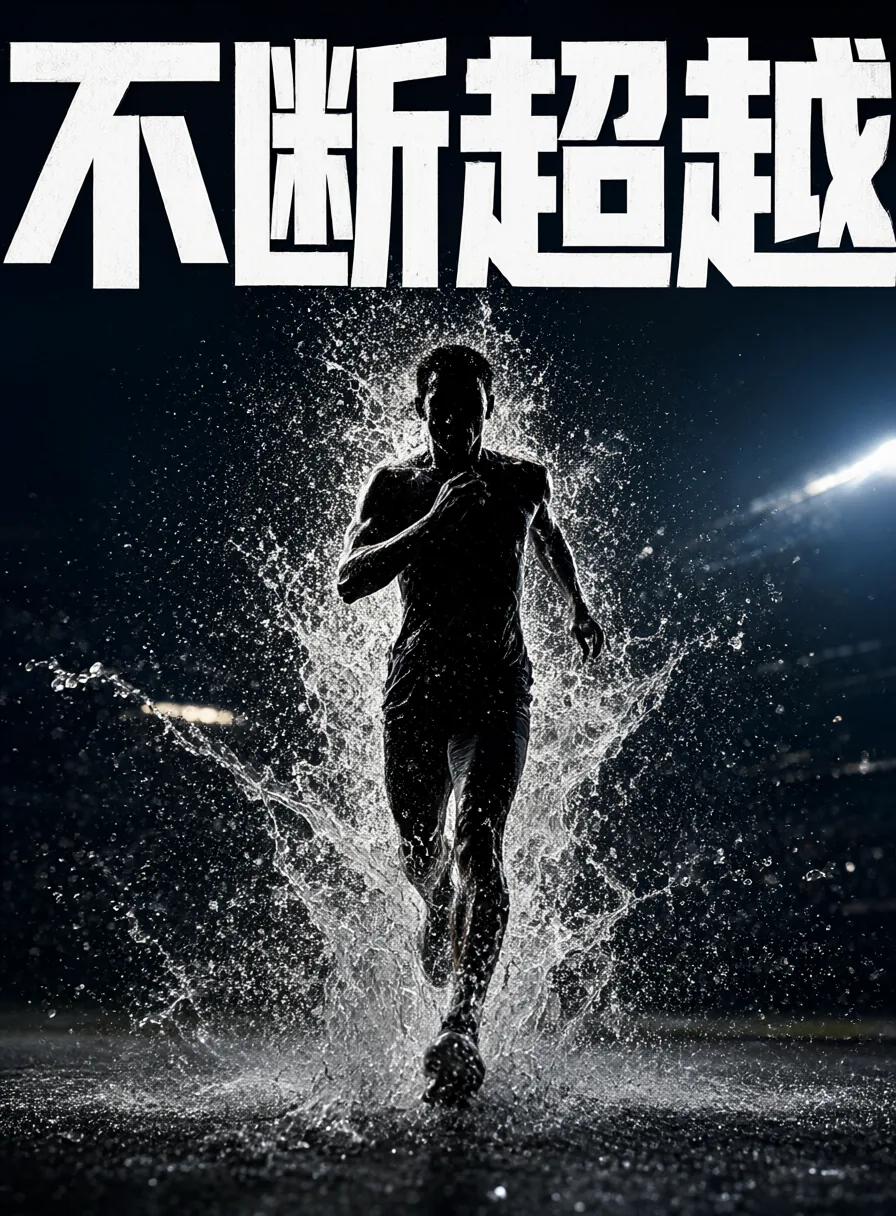
C · 真人写实(896×1216)
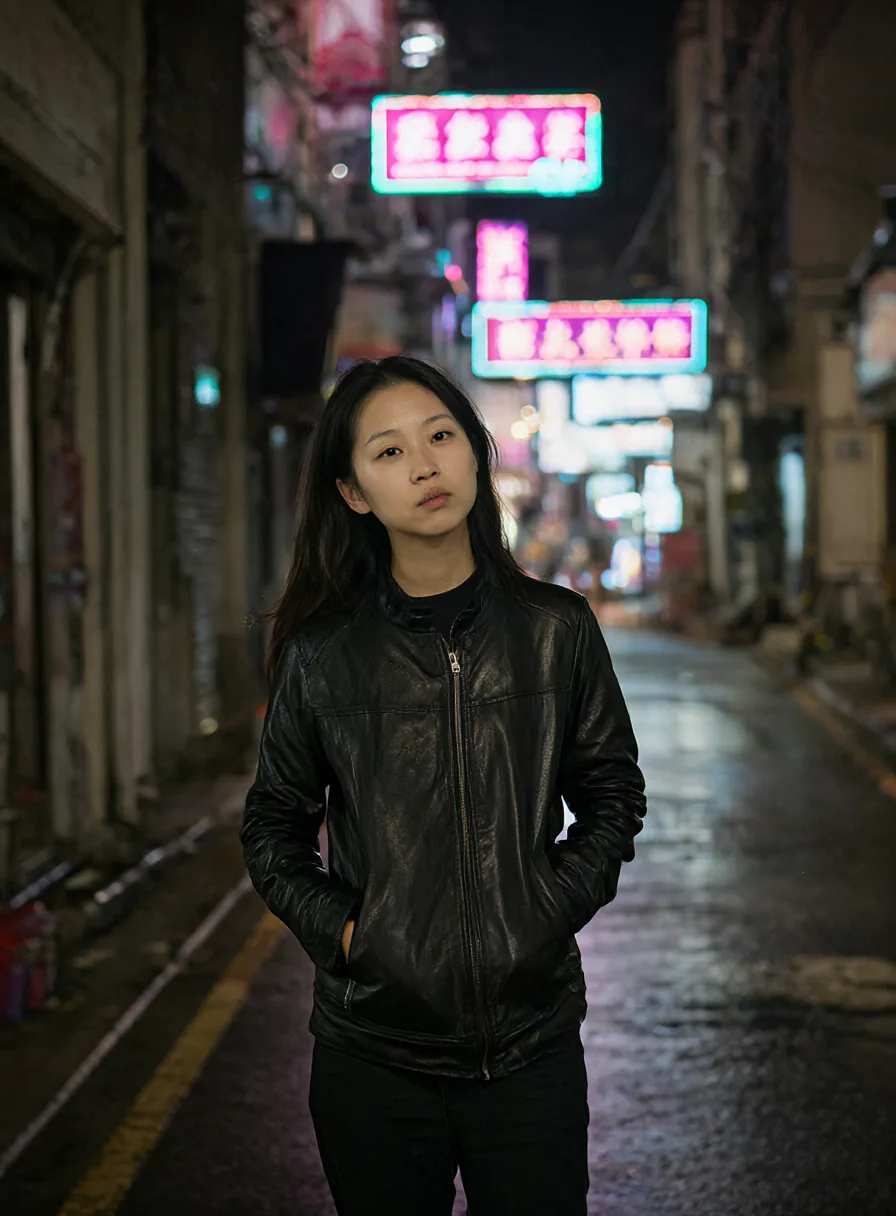
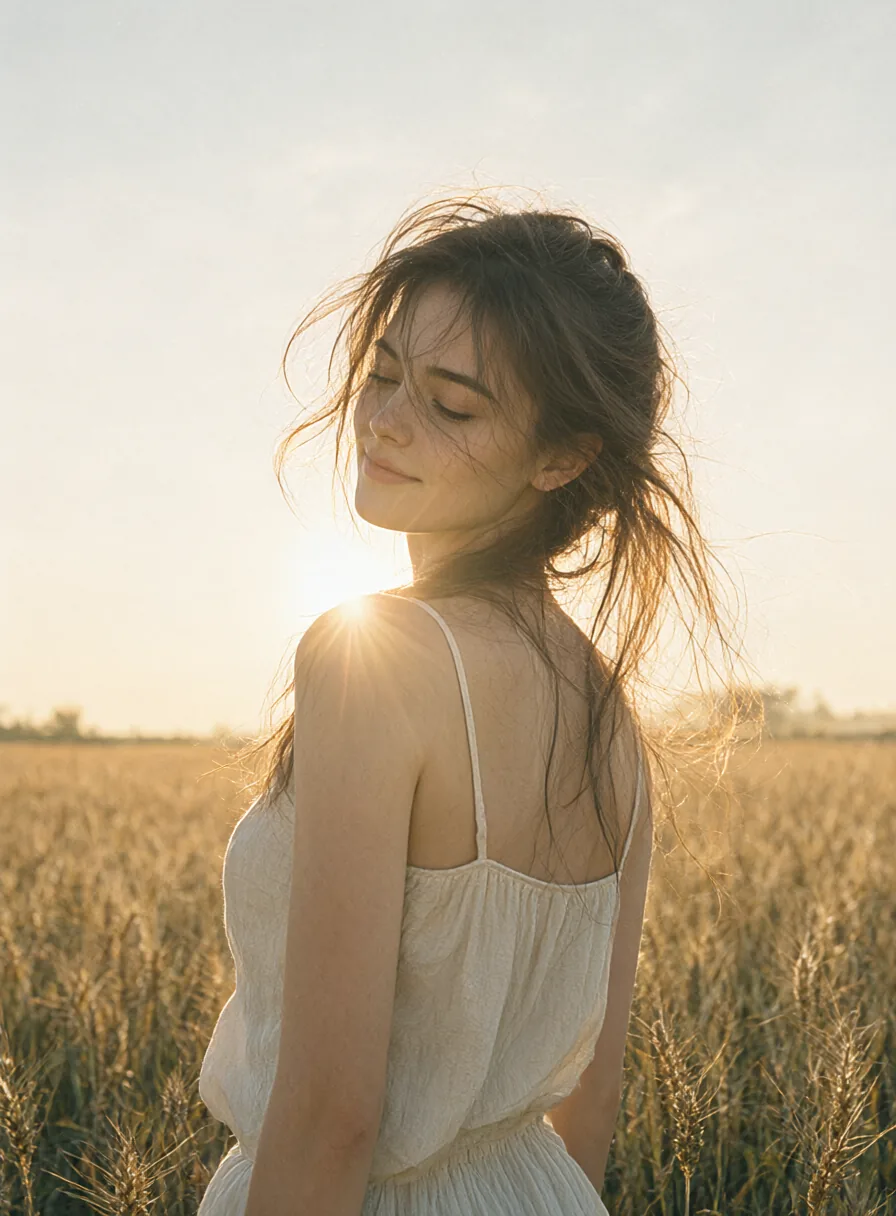
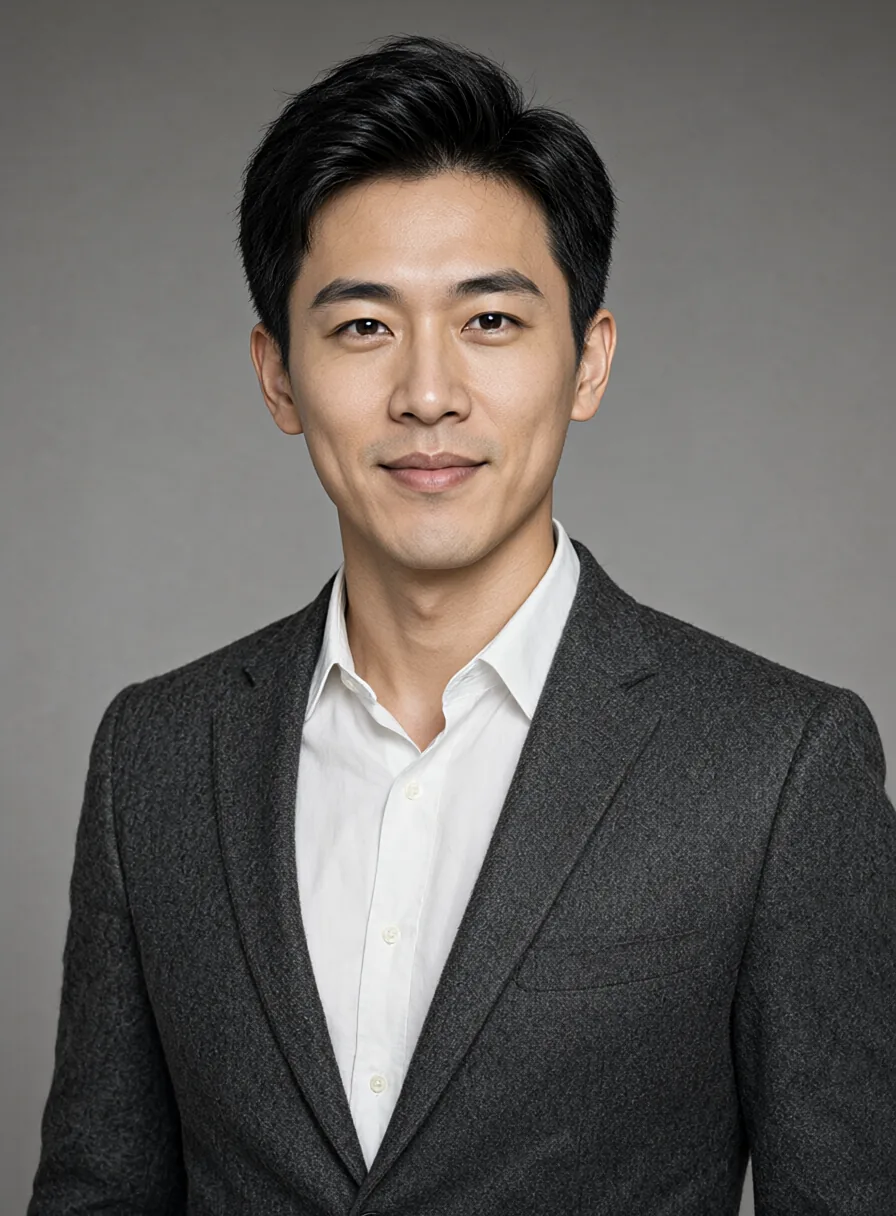
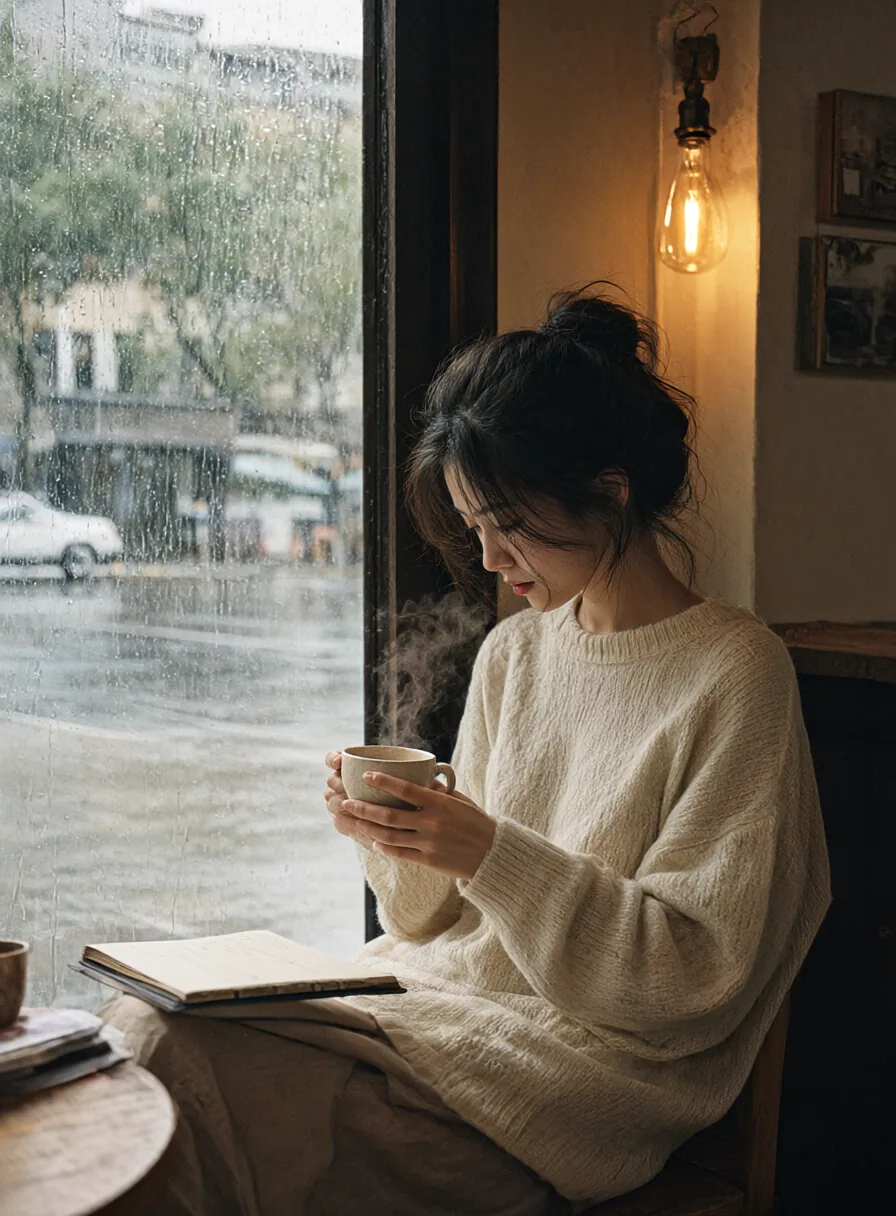
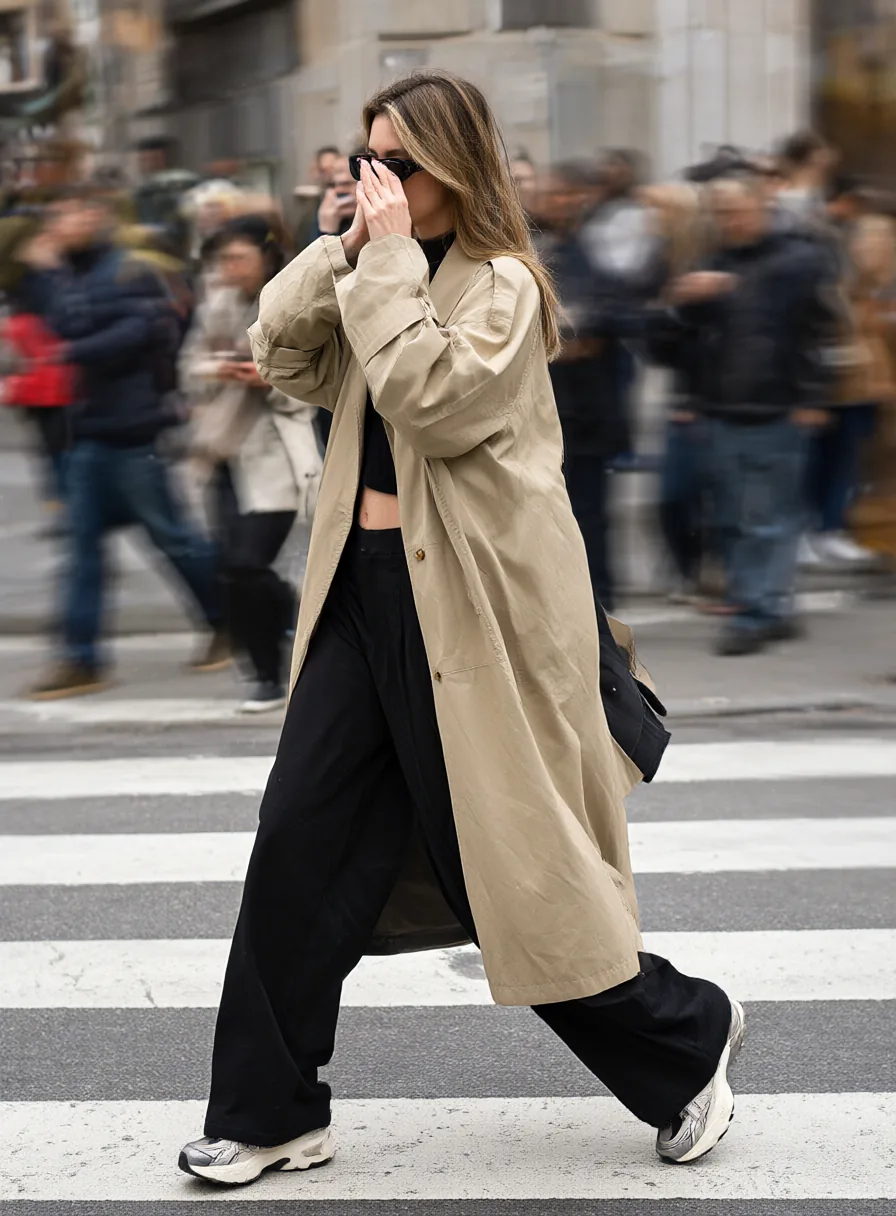
D · 二次元与插画(896×1216)
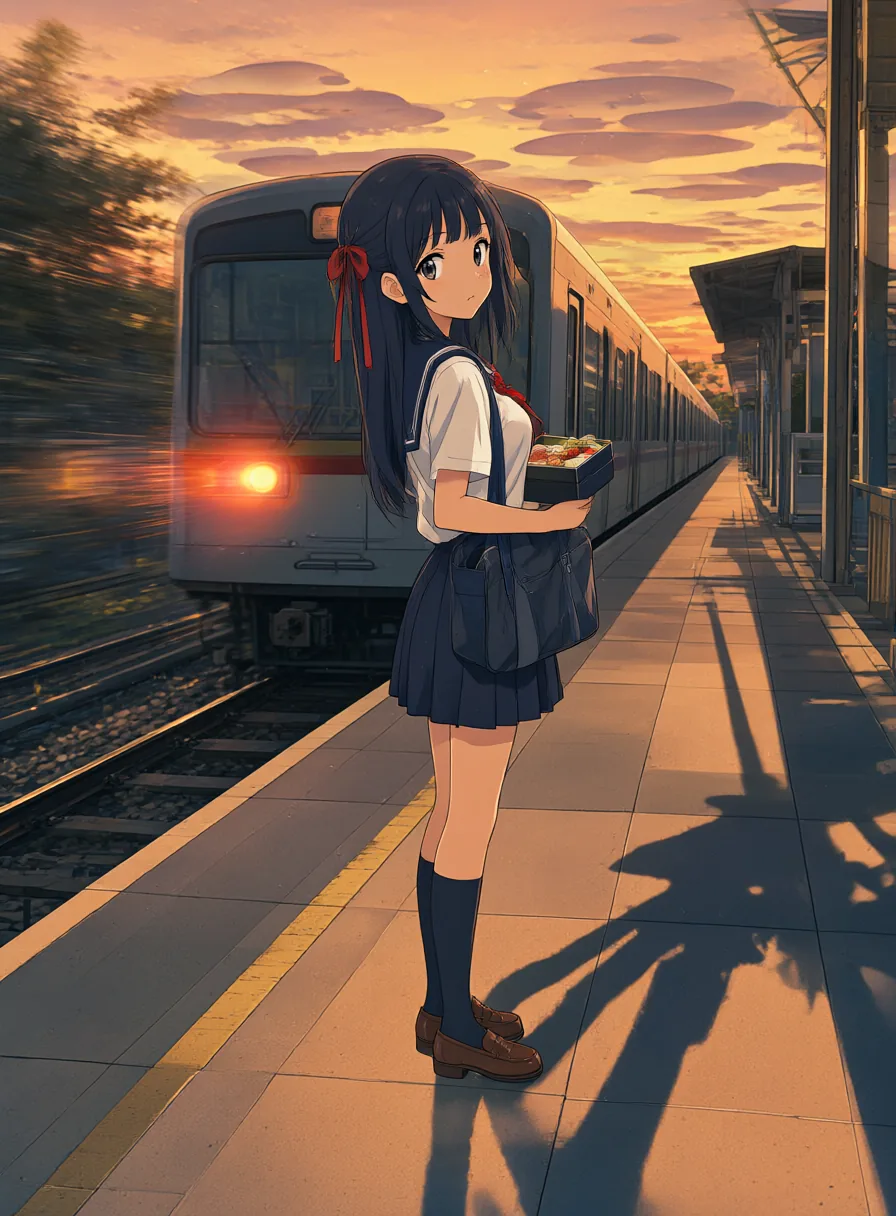
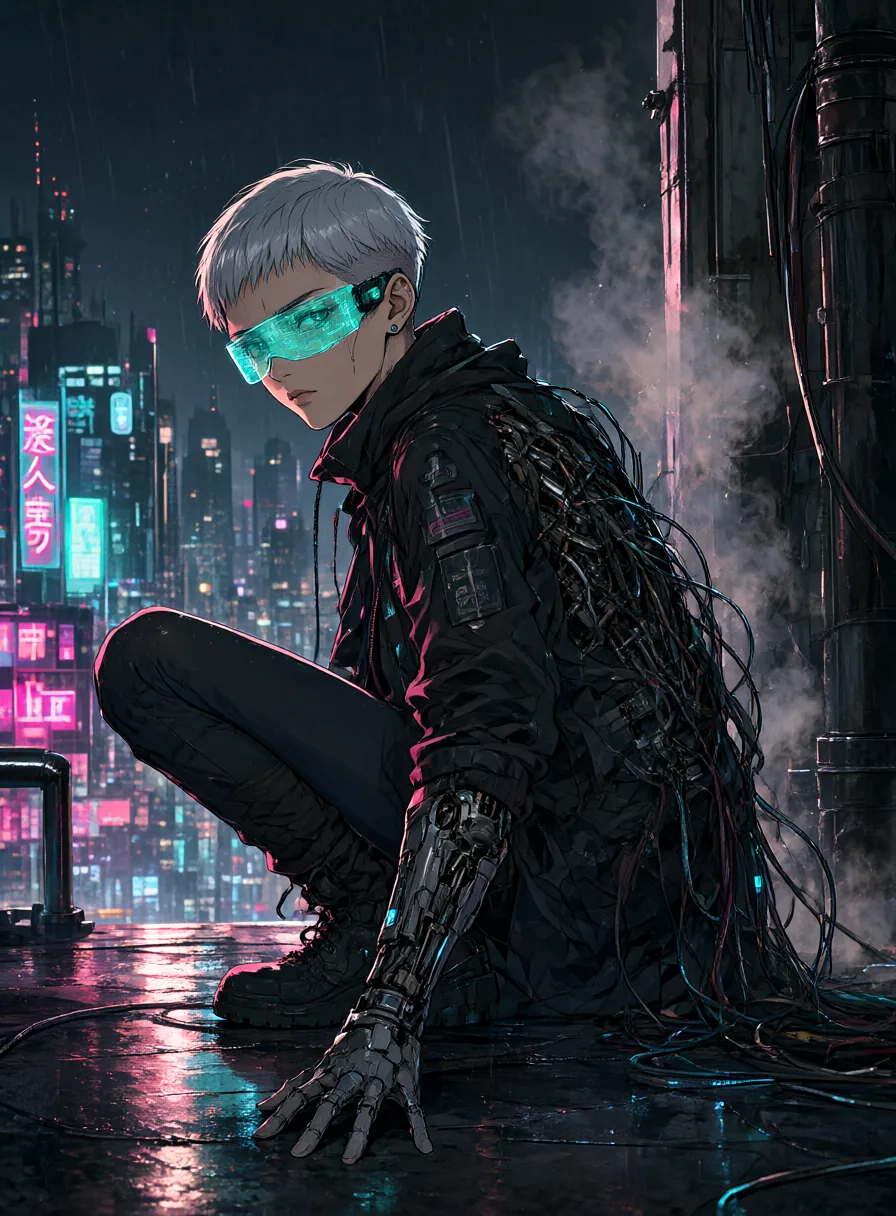
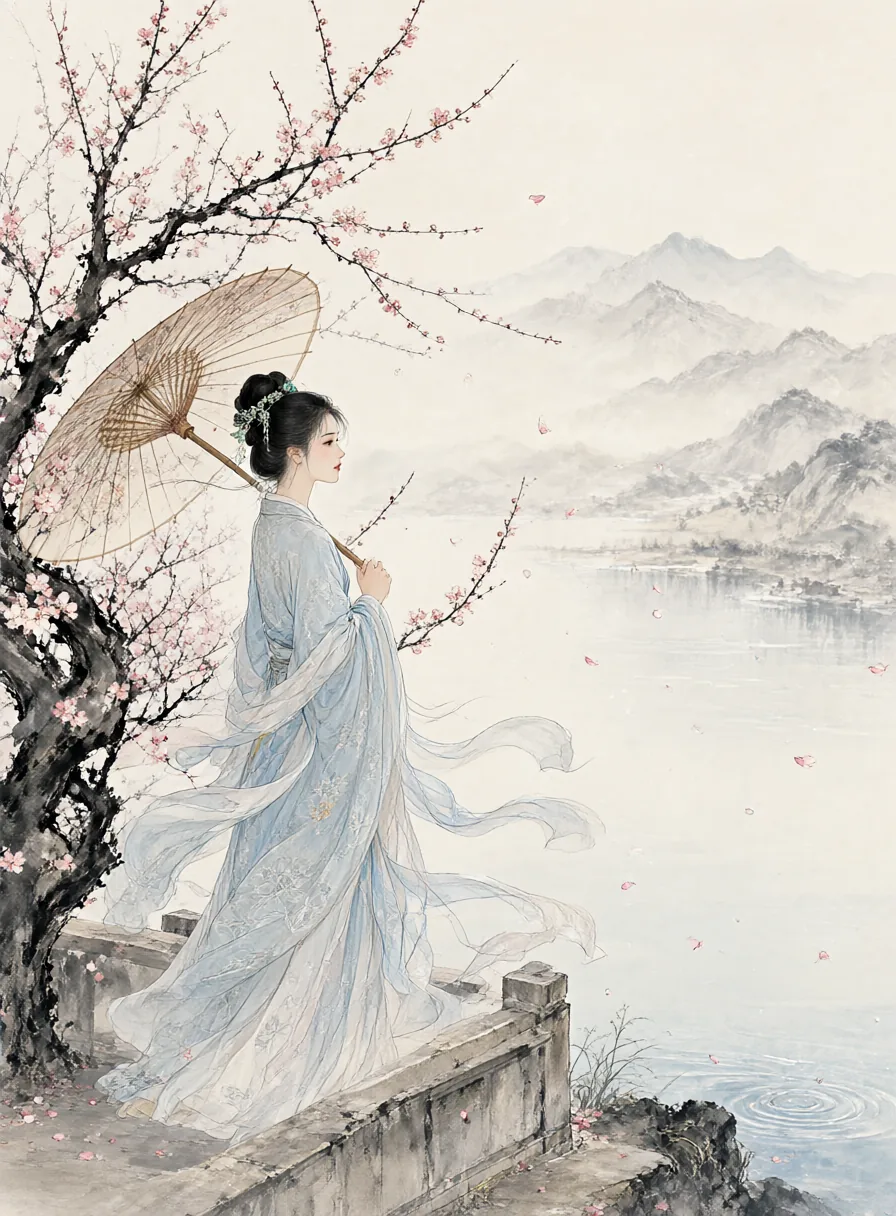
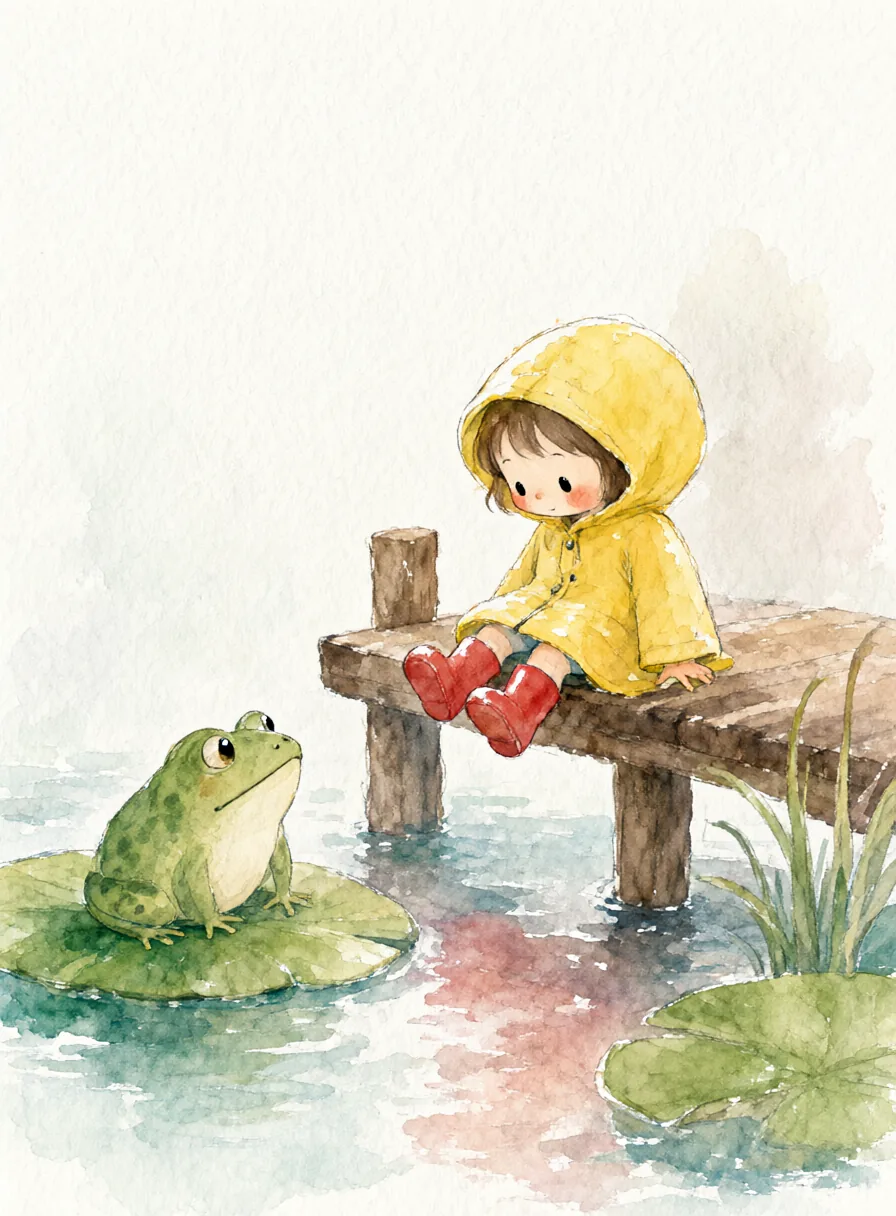
E 组的 12 张是图像编辑,必须配原图对照才看得出能力,放在下面「图像编辑」一节。
配置清单
硬件与软件
| 项目 | 实际值 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Laptop(Blackwell / sm120) |
| 显存 | 8 GB |
| 内存 | 16 GB |
| 系统 | Windows |
| ComfyUI | 0.37.0(前端 1.53.6)——正好是官方测试过的版本 |
| 管理方式 | 绘世启动器 2.9.1,本地端口 10809 |
| 启动耗时 | 约 115 秒到可服务 |
四份权重
| 目录 | 文件 | 本机实测 | 官方标称 |
|---|---|---|---|
diffusion_models/ |
qwen_image_2.1_int8_convrot.safetensors |
6.76 GiB | 7.3 GB |
text_encoders/ |
qwen3vl_8b_int8_convrot.safetensors |
8.71 GiB | 9.4 GB |
vae/ |
qwen_image_2.1_vae_bf16.safetensors |
0.63 GiB | 0.7 GB |
loras/ |
Qwen-Image-2.1-viggle-turbo-v0.2-5step-lora-r128.safetensors |
0.63 GiB | 0.7 GB |
两栏体积对不上是单位问题,不是文件有问题。官方按 109 报(GB),本机按 230 报(GiB):7.3 GB = 6.80 GiB、9.4 GB = 8.75 GiB,一一对应。看到别人报的数字差 7%,先看单位再怀疑文件。
启动参数
--lowvram --fp8_e4m3fn-unet --use-sage-attention --enable-managerqwen_image_2.1_int8_convrot 本身已经是 int8 量化权重,--fp8_e4m3fn-unet 对它基本是空转。真正让 7 GB 级模型在 8 GB 卡上跑起来的,是 ComfyUI 的动态显存换入换出。这条值得记住:显存不够时,量化策略与调度方式比启动开关重要得多。
这套加速 LoRA 是什么
它是 Qwen-Image 2.1 的蒸馏学生模型,用 DMD(Distribution Matching Distillation)训练:5 次 transformer 前向代替 40 次,并且完全不需要 CFG。
装的是 r128 版。官方用逐层 SVD 从 r256 精确截断得到,每层保留 83–100% 的更新能量(中位 95%),与 r256 的图像差异 LPIPS 只有 0.0244——已经落在浮点舍入噪声线上(同一套权重重新做一次分解就有 0.0239)。所以没有升级 r256 的必要,白省 0.7 GB。
官方原话是:「The LoRA is never merged into the transformer — merging into bf16 is lossy, loading it at runtime is exact.」不要把它合并进模型,运行时挂载才是精确的。这条要求会直接变成后文的速度代价。
6 步为什么不是妥协
采样调度用的不是默认值,而是一张自定义 sigma 表:
1.0, 0.9375, 0.875, 0.75, 0.5, 0.25它其实就是 4 步训练调度 linspace(1, 1/4, 4),把最高噪那一段 1 → 0.75 切成三份。形状不是随手定的,官方给了三条理由:
- 要改步数,只能在高噪声端增删。低噪声端的节点不能碰。
- 构图在 raw sigma
1 → 0.875之间就被定下来了。这一段如果用一个跨度过大的单步,画面会重影或漂移。 0.75 / 0.5 / 0.25是学生模型被训练来落点的地方。动它们会让每一张图都变软——拉普拉斯锐度从 0.020 掉到 0.014。
| 步数 | 构图稳定性 |
|---|---|
| 4 步 / 5 步 | 提示词构图漂移 4% |
| 6 步 | 漂移 0% |
| 7 步 | 稍锐,但看不出比 6 步好 |
6 步是这份 LoRA 的甜点,不是向速度妥协的结果。更少会漂,更多没有收益。
速度实测
| 文生图 20 张 | 值 |
|---|---|
| 单张耗时范围 | 16.1 – 26.3 秒 |
| 总计 | 364.7 秒(6.1 分钟) |
| 平均 | 18.2 秒 / 张 |
| 失败数 | 0 |
| 图像编辑 12 张 | 值 |
|---|---|
| 单张耗时范围 | 33.4 – 55.7 秒 |
| 总计 | 521.0 秒(8.7 分钟) |
| 平均 | 43.4 秒 / 张 |
| 失败数 | 0(其中 1 张重做一次,见下文) |
| 合计 | 张数 | 耗时 | 平均 |
|---|---|---|---|
| 文生图 | 20 | 6.1 分钟 | 18.2 s |
| 图像编辑 | 12 | 8.7 分钟 | 43.4 s |
| 总计 | 32 | 885.7 秒 ≈ 14.8 分钟 | 27.7 s |
编辑比文生图慢约 2.4 倍,多出来的就是一次参考图编码。另一个观察是:同一批连跑时第一张要约 49 秒(模型换入),之后稳定落到 33–37 秒。
端到端加速比:40 步基线实测 62.6 秒(1376×768),6 步 + 加速 LoRA 是 18.2 秒,面积相差 3% 以内可比,约 3.4 倍。但有三个「但是」必须一起说清楚。
- 加速 LoRA 本身有净代价。用一组严格同条件的 A/B 测出来(同提示词、同 seed、同 sigma,唯一变量是挂不挂 LoRA 节点,1248×832):挂上时是 2.40 / 2.33 秒每步、整次 31.36 秒;摘掉后是 1.86 / 1.70 秒每步、整次 21.42 秒。原因是官方要求运行时挂载、不许合并,每步就多一层运行时钩子。官方说这个代价是 10–25%,但那是 bf16 + 大显存下的数字,8 GB 卡上明显更高。
- 非采样开销不随步数缩放。40 步基线拆开是 62.6 秒 = 文本编码 7.5 + 采样 51.3 + VAE 解码 2.3。步数从 40 降到 6,那约 9.8 秒的非采样时间一分没少——这正是加速比上不到 40/6 ≈ 6.7 倍的原因。
- 冷启动要另算。单跑一次(含模型加载)实测 27–31 秒,只有批量连续出图、模型常驻时才降到 18.2 秒的均值。引用任何一个秒数,都要交代分辨率、是否冷启动、模型是否常驻。
加速 LoRA 的收益要按「固定开销 + 步数 × 每步耗时」来算,只乘每步倍率一定会高估。
排产上给个实用建议:做作品集按「文生图 20 秒、编辑 1 分钟」估就够了,不必照最慢那张算。
中文渲染:13 处字串零错字
这是 Qwen-Image 系列最核心的卖点,而这套链路是 6 步蒸馏——蒸馏通常被认为会牺牲细节。实测没有。下面 8 处图内文字、共 13 个中文字串,逐张放大目视核验后:笔画正确、边缘干净、零错字。
| 出处 | 图内文字 | 字体特征 |
|---|---|---|
| 上图 06 电影海报 | 「山海」+「一场关于远方的梦」 | 书法体大字 + 小字 |
| 上图 07 茶饮海报 | 「夏日限定」+「冷萃茉莉 第二杯半价」 | 圆体粗字 + 灰色小字 |
| 上图 08 音乐节海报 | 「回声音乐节」+「10.18 杭州」 | 超粗压缩体 + 日期数字 |
| 上图 09 书店海报 | 「慢下来,读一页」 | 细体、大字距,含中文逗号 |
| 上图 10 运动海报 | 「不断超越」 | 超粗压缩体,有意裁切出画 |
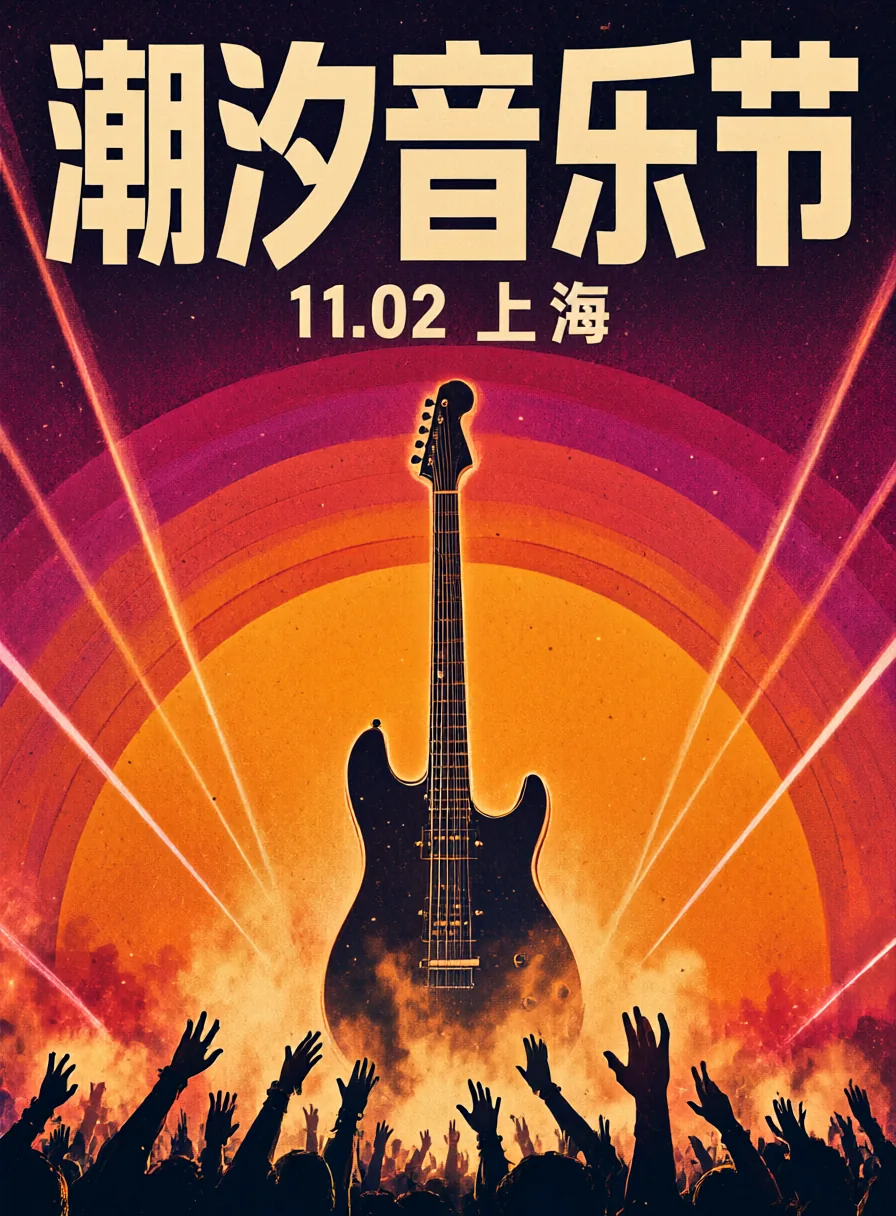
| 下文 29 改文案(编辑) | 「潮汐音乐节」+「11.02 上海」 | 与原图逐字同字体、同色、同位 |
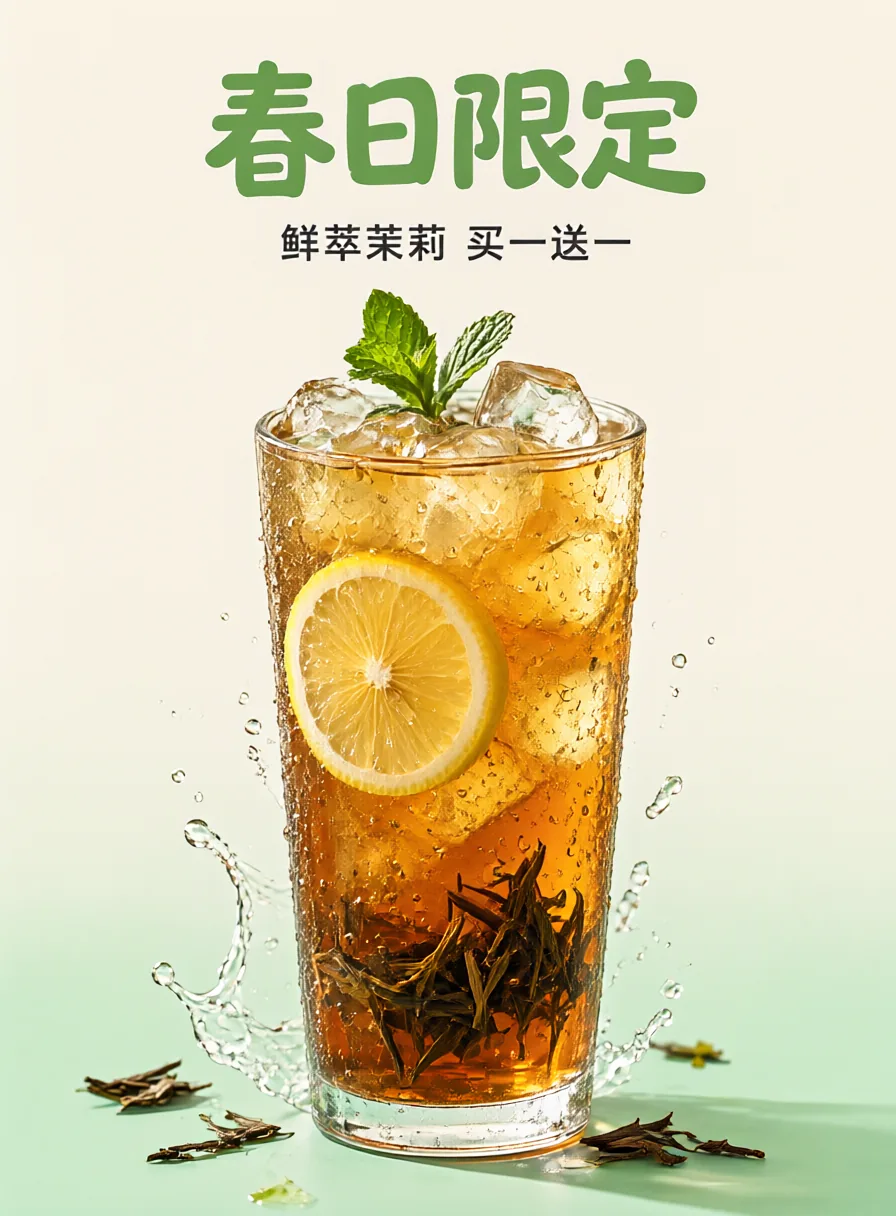
| 下文 30 改文案(编辑) | 「春日限定」+「鲜萃茉莉 买一送一」 | 同上 |
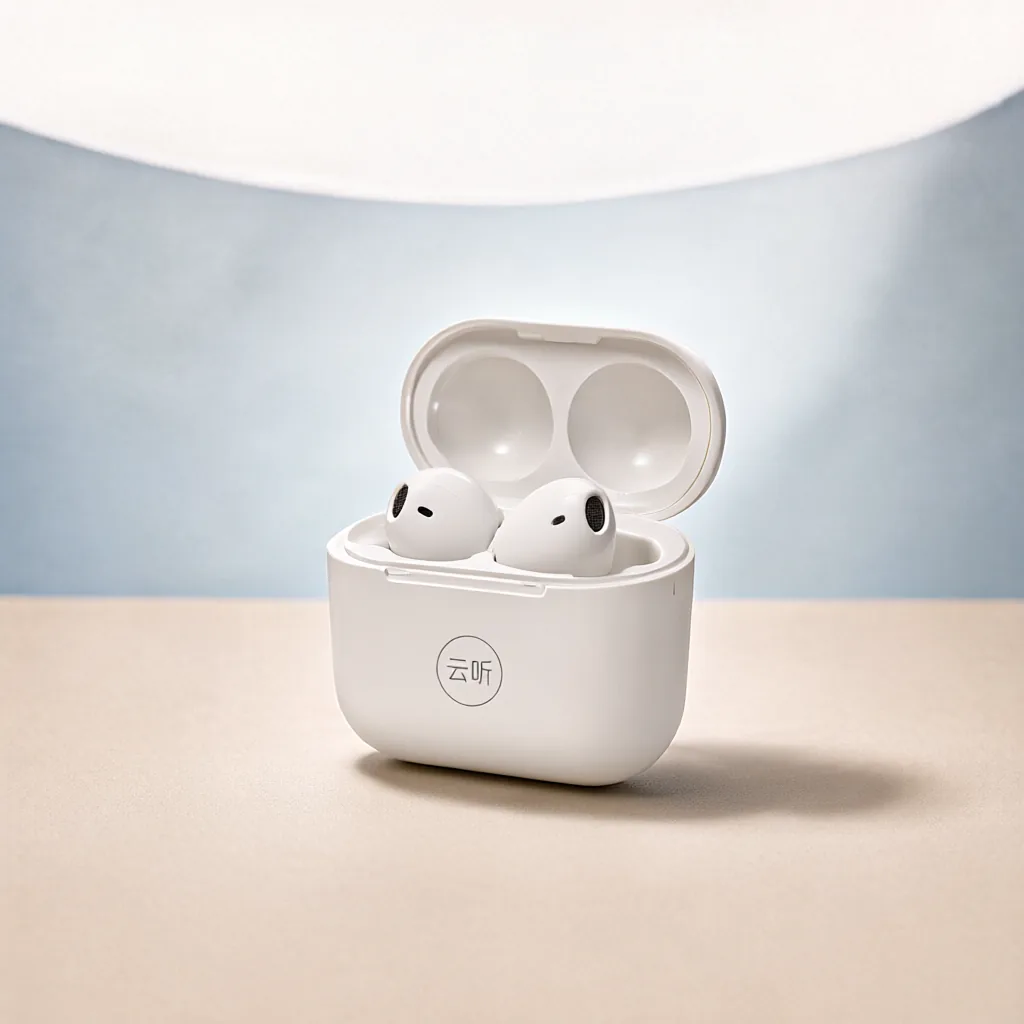
| 下文 32 加 Logo(编辑) | 「云听」 | 细线圆环内,带曲面透视 |
两条可以直接带走的结论:
- 海报类不需要为了文字拉高步数,18 秒一张就够。
- 编辑类更狠。「潮汐音乐节」是四个超粗压缩体汉字,换掉之后字形、颜色、字距与原版逐字一致;耳机 Logo 放大 5 倍看,「云听」两笔一画全对,圆环还正确贴合了充电盒的曲面透视。
官方「Known limitations」里明确说了:「Small or long rendered text can garble more often than with the 40-step base model.」本次 13 处全部是短串(1–8 字),表现很好;不要外推成「长段落文字也没问题」。
图像编辑:它不是 img2img
这一段是全文最值得带走的技术细节。大多数人以为图像编辑就是「把原图当底图重画一遍」,但这套链路的机制不是那样——它更接近「在原图所在的坐标里重算」。三条依据:
- 编辑链里的
resolution不是输出尺寸,而是参考图编码的目标面积。它配合源图的宽高比取整到 32 的倍数,恰好回到源尺寸——896×1216 的源图取 1056 就回到 896×1216。所以参考图是零缩放的,输出也自然是同尺寸。 - 编辑用的空 latent 必须由文本编码节点给出。它按参考图尺寸构造;官方的接线里有一个开关专门走这条路,不能随手换成别的尺寸节点。
- sigma 节点是从「喂给采样器的那个 latent」的 token 数推动态 shift 的。所以两处必须共用同一个 latent,否则调度参数会和实际输入对不上。
节点源码注释的原话是「any other size shifts the edit」——任何其它尺寸都会让编辑跑偏。
实测结果支持这一点:12 张编辑的输出全部与源图逐像素同尺寸(1024×1024 → 1024×1024,896×1216 → 896×1216)。
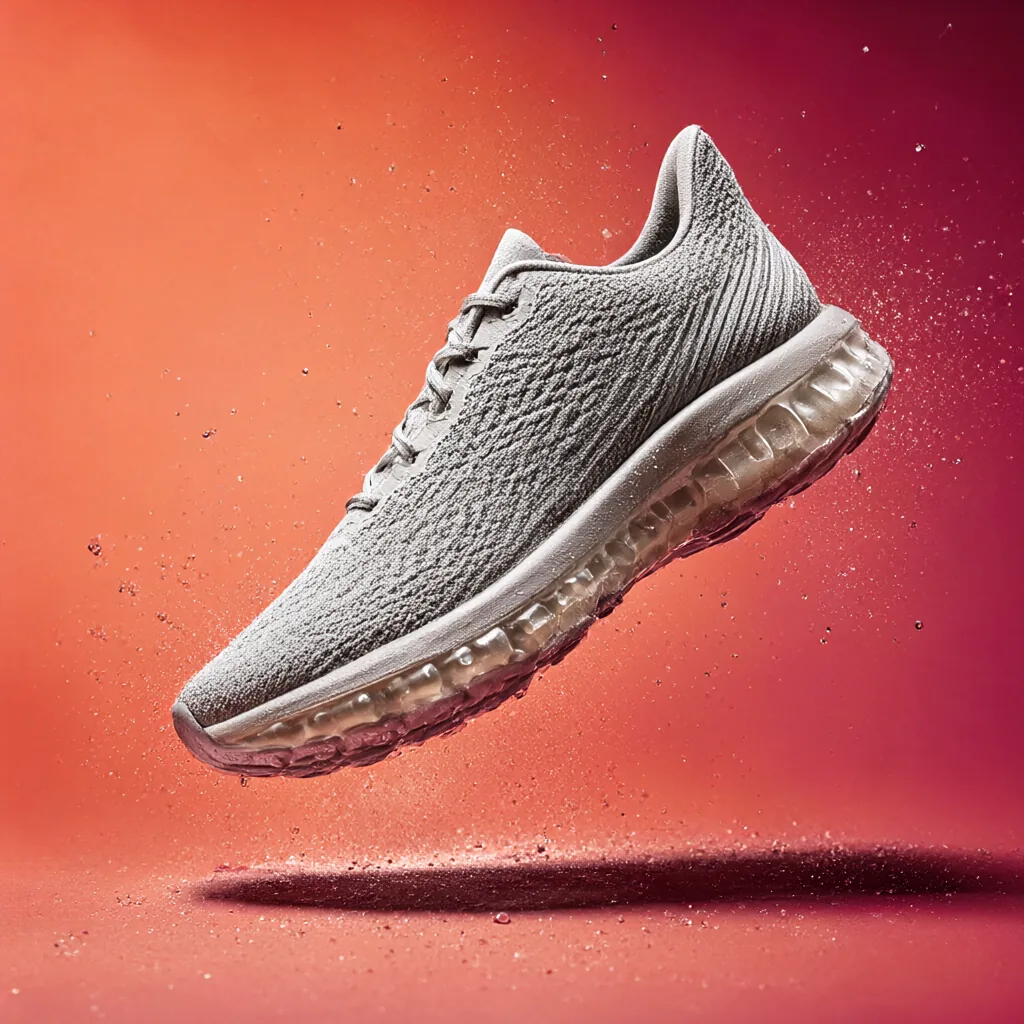
E1 · 换色:同一张跑鞋,三种配色
灰跑鞋换成柔粉 / 钴蓝 / 哑黑。三张都完整保持鞋型、编织纹理、鞋带、中底颗粒、悬浮姿态与落地投影。
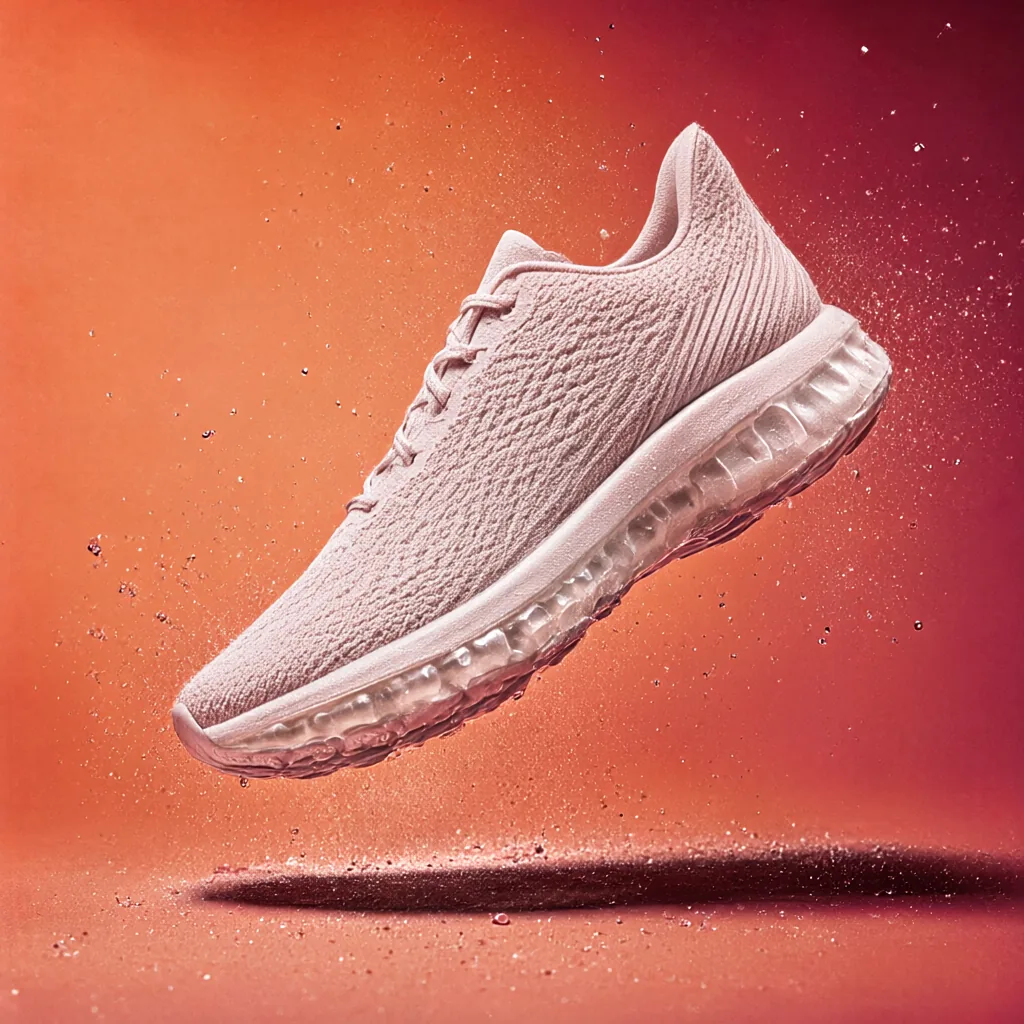
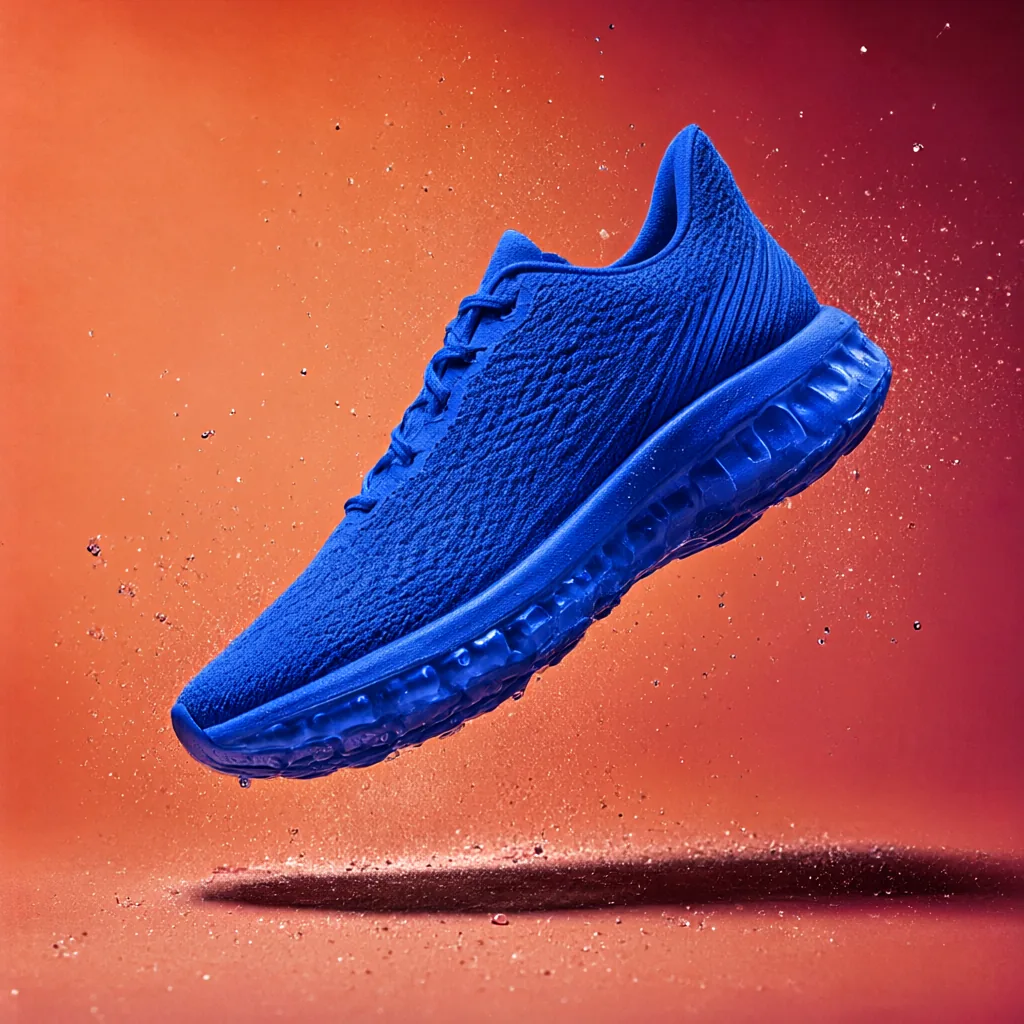
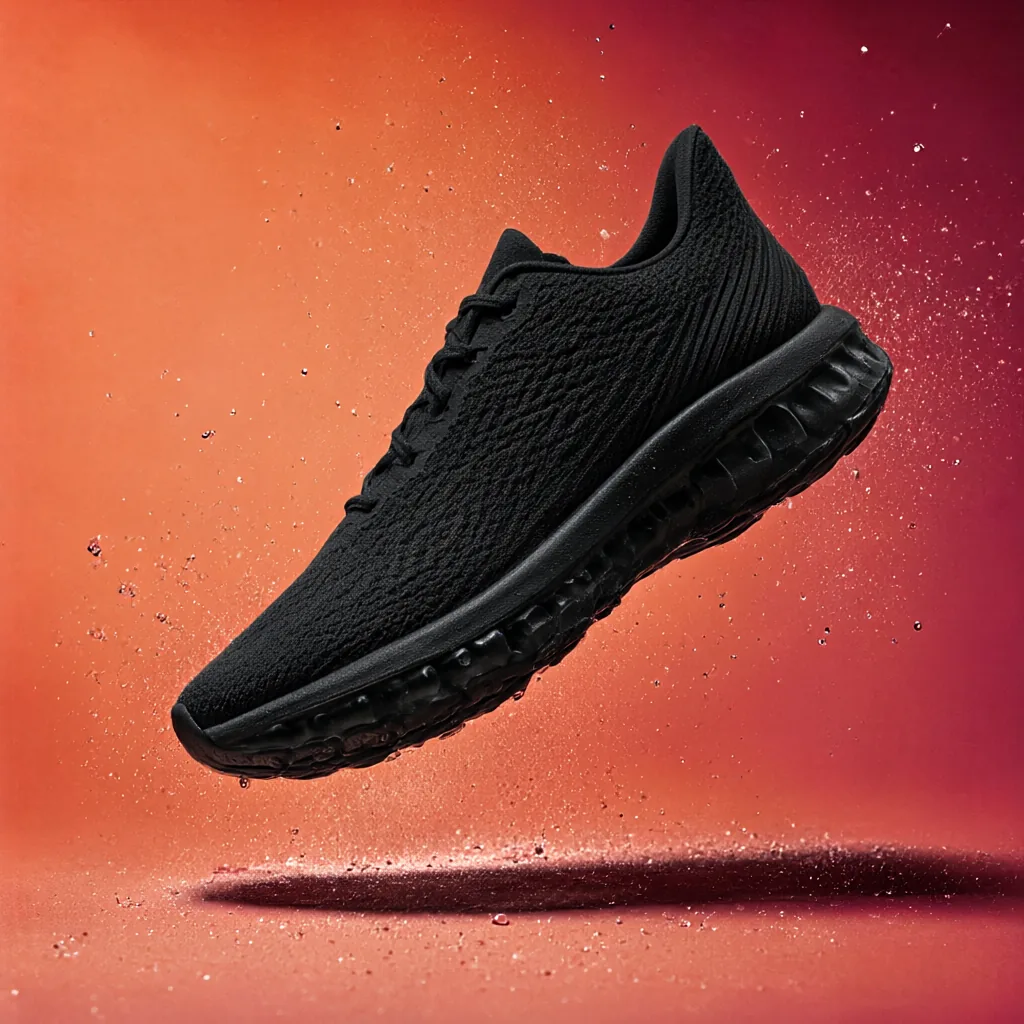
这三张是重跑后的结果。第一版曾把背景带成浅粉、黑鞋那次还压暗了背景;加强「背景锁定」约束后重跑才达标——三张的背景色调偏移 ΔRGB 全部小于 10。
E2 · 换局部环境:同一个窗外,三个季节
同一张书店海报,只换窗外的树。书的开合角度、书页层次、桌沿、窗框比例,以及「慢下来,读一页」这 7 个字,四张里完全一致。
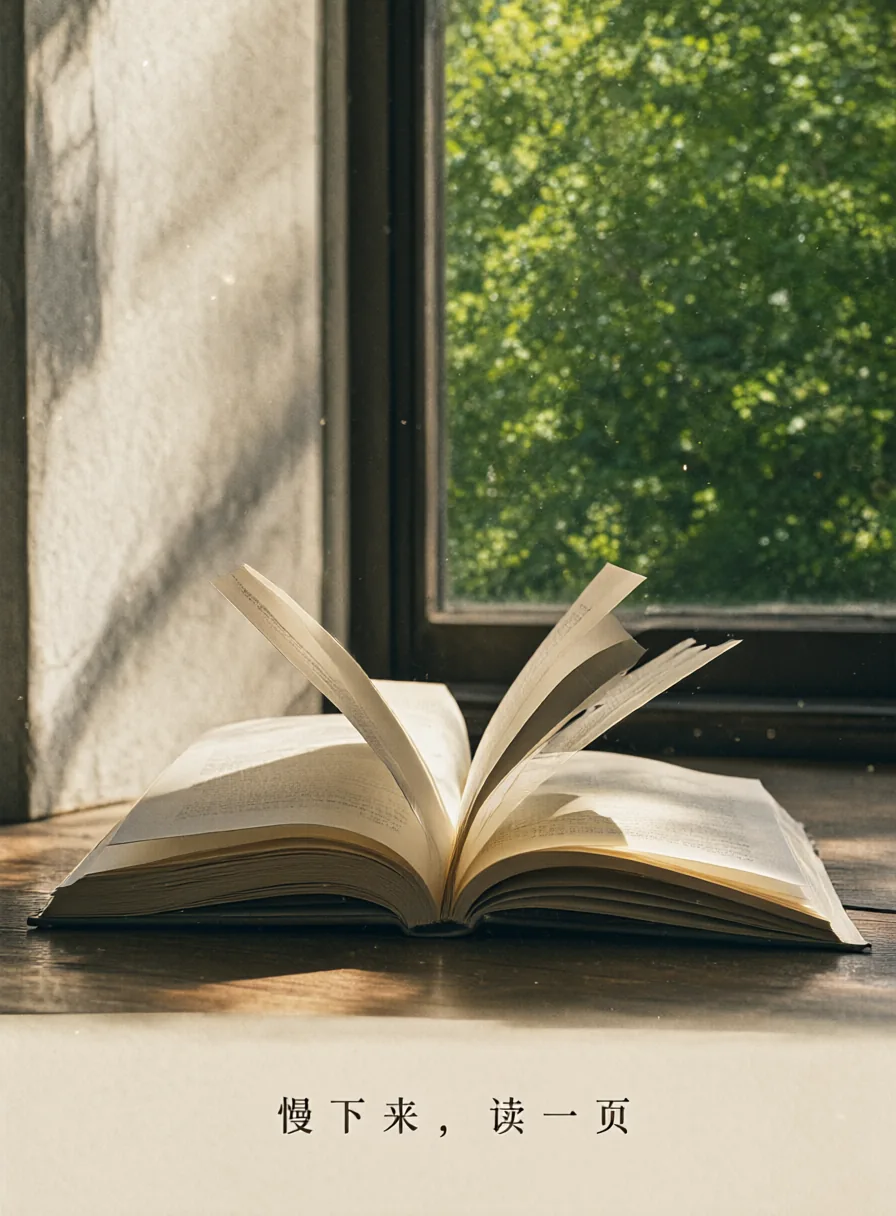
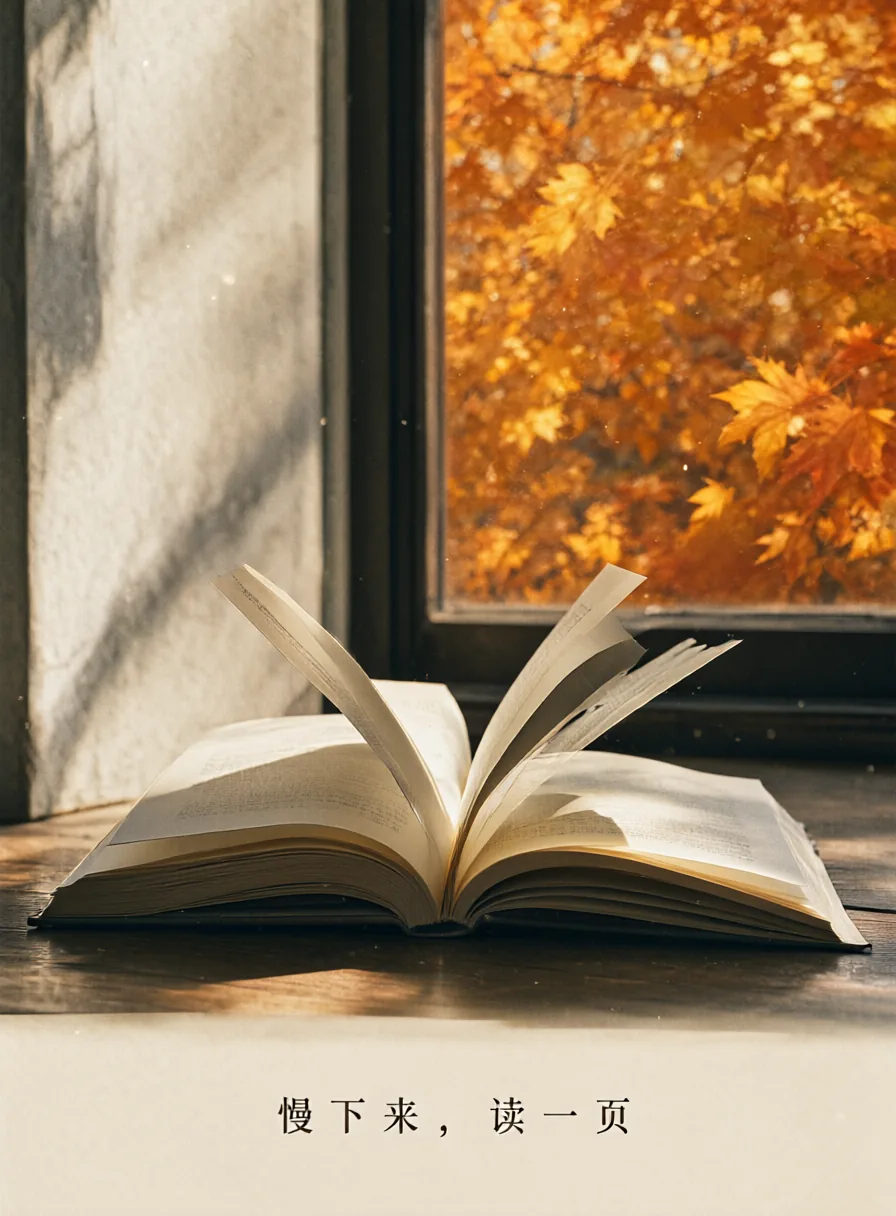
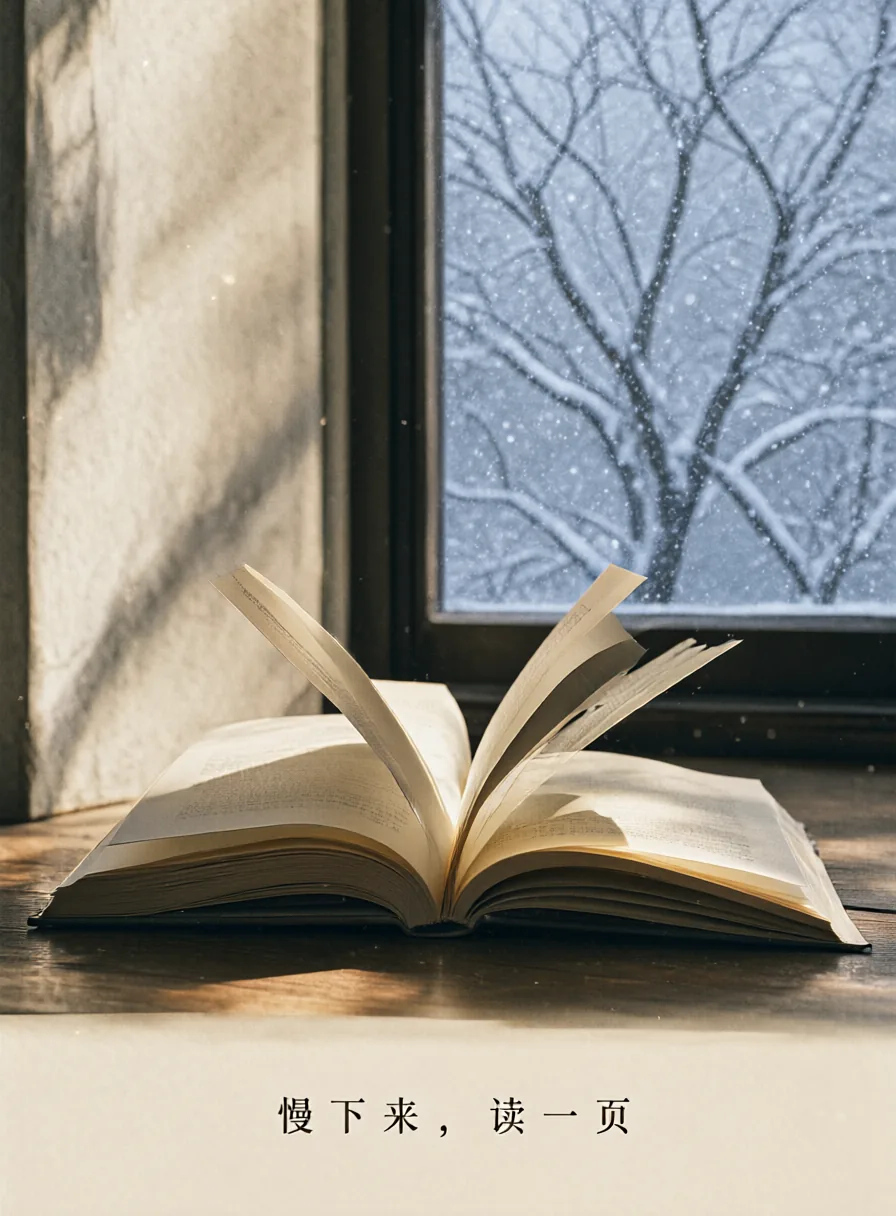
秋、冬两版的墙面光斑与投影会跟着变(橙金反光、冷蓝枝条影)。这不是缺陷,是物理正确的表现——光变了,投影就该变。夏天版边缘几乎没动,是因为暖光条件本来就接近原图。
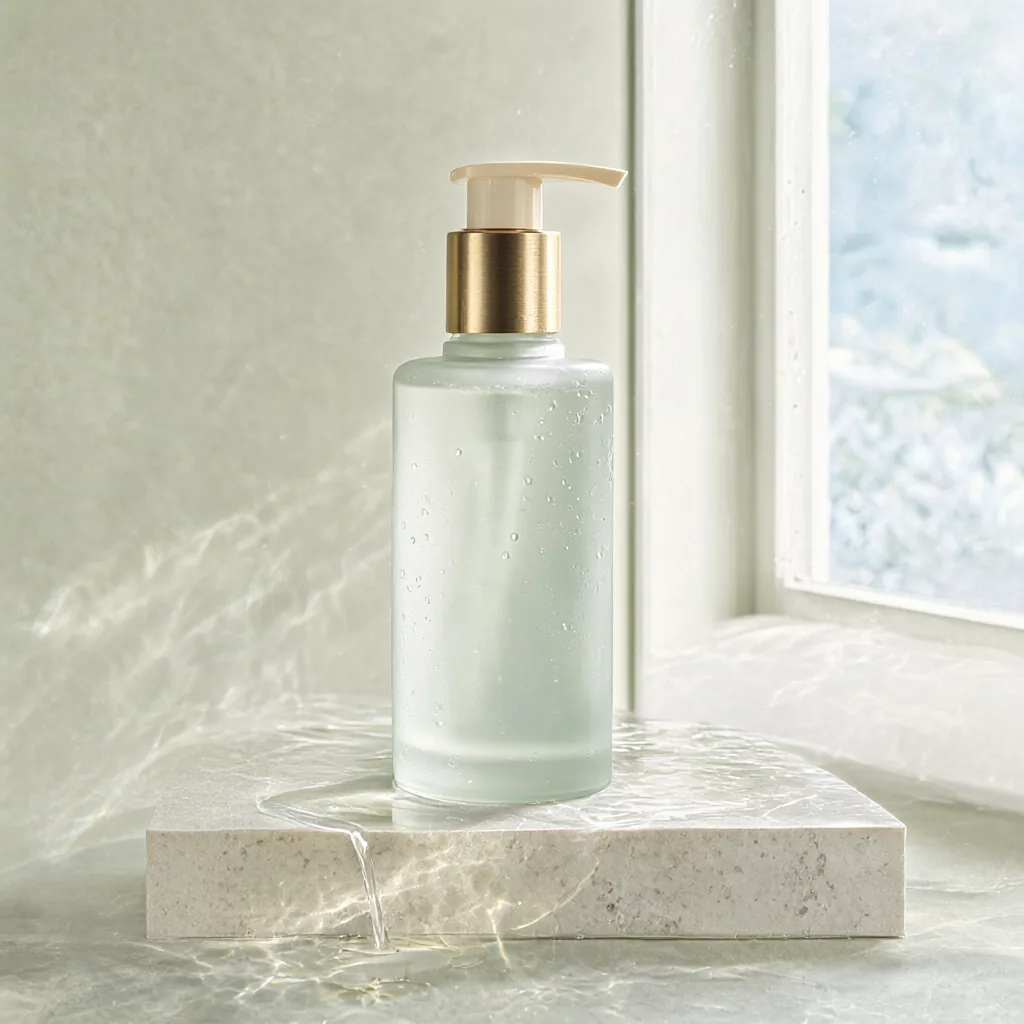
E3 · 移除与替换物体
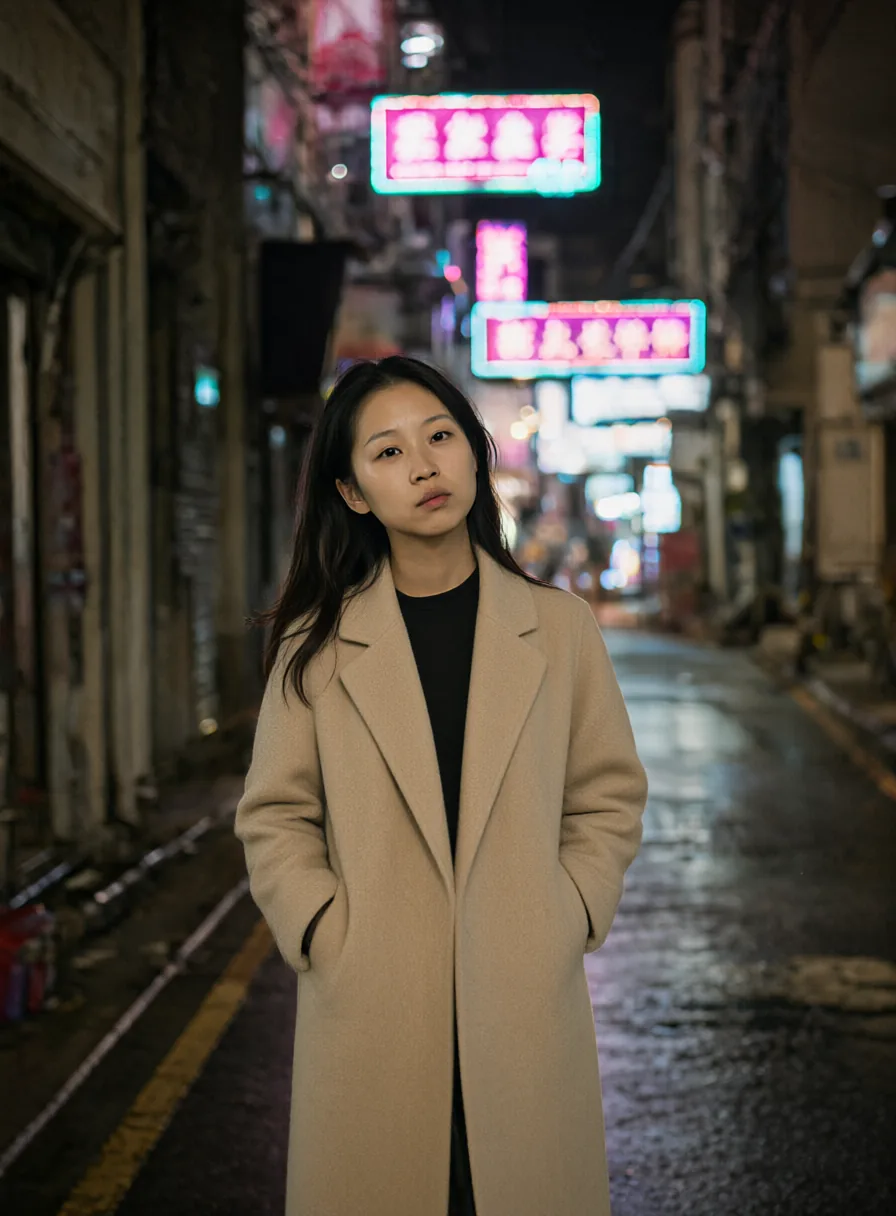
E4 · 改写图中文案
这类编辑最难的地方不在「写对字」,而在保持字体、颜色、字距、位置全部一致。
E5 · 改材质与加 Logo
保真度是量过的,不是嘴上说的
换色组测了背景色调偏移(ΔRGB 均小于 10);换季组核对了书的开合角度、书页层次、桌沿、窗框比例与 7 个字的一致性。按实际稳定性,编辑任务可以粗分两档——这是本机经验,不是官方结论:
| 保真度 | 编辑类型 |
|---|---|
| 稳 | 换色、改图中文案、加 Logo、删物件、换衣服 / 配饰 |
| 会漂 | 反射类材质(金属微距)——需要按下面的方式逐部件点名 |
唯一重做的一张,以及它教了什么
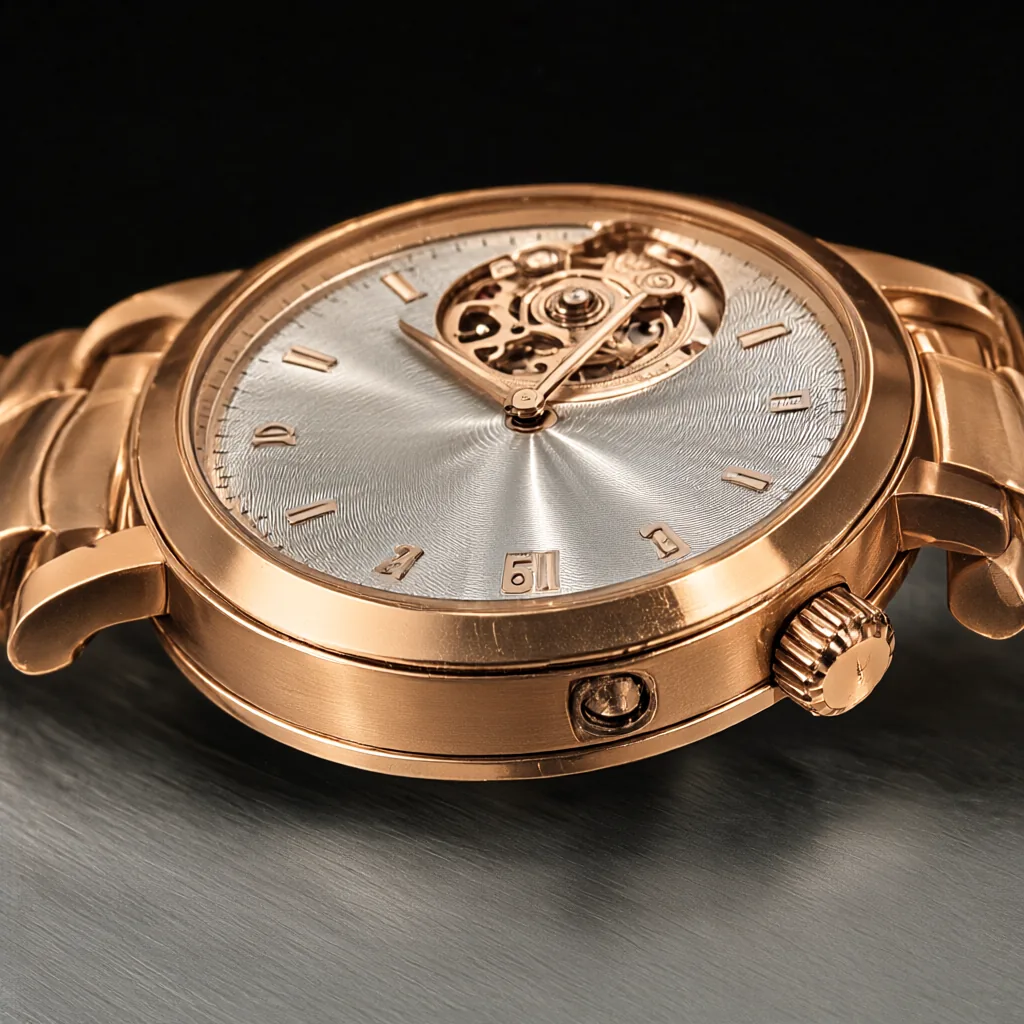
腕表换玫瑰金的第一版是失败的:表壳确实变玫瑰金了,但背景从纯黑漂成浅灰、机位从斜躺变正面、表盘被一起染成金色——三处全错。重写指令之后才全部拉回。
根因是:keep everything else unchanged 这类笼统约束根本不管用。有效的写法是逐条点名:
| 要点名的东西 | 反例(无效) | 正例(有效) |
|---|---|---|
| 背景的颜色与明暗 | the same background | the same very dark near-black background, the same dark brushed titanium surface |
| 主体的每个部件 | keep the watch the same | the same silvery-white dial plate, the same fine guilloche texture, the same applied indices, the same hands |
| 机位与裁切 | 「保持构图」 | the same position, the same orientation, the same tilt and the same crop |
官方也承认这一点:「『keep everything the same』requests can drift in identity.」——我在这台机器上完整复现了这个现象。
踩坑记录
- 参考图会静默丢失。源图明明是灰跑鞋,生成出来的却是一双粉色 Nike AF1——完全是另画一双。原因是 autogrow 类型的输入在 API 里必须写成点号平铺(
images.image_1),写成嵌套字典{"image_1": …}不报错、静默忽略。这类错误最难查,因为日志里一切正常。 - 代理会劫持本机回环。轮询任务时收到 HTTP 502,一度以为服务崩了。实际是环境里的代理变量被客户端遵守,连 127.0.0.1 都走了代理。记住:那个 502 是代理报的,不是服务报的。解法是显式禁用代理。
- 服务被外部终止,而日志里没有任何堆栈。连续两次中途死掉。第二次更冤——成品其实已经生成完了(55.7 秒),脚本死在复制文件那一步。所以遇到这种情况先去输出目录把「孤儿成品」捡回来,不要重跑。根治办法是在一个前台进程里串起「启服务 → 出图 → 收工」,让服务与任务同生共死。
- 提示词增强器在抢显存。官方工作流默认开启,但开着比出图本身还慢——它要跑本地 8.7 GiB 的文本编码器做自回归生成(最多 512 token),和 6.76 GiB 的 DiT 抢 8 GB 显存。关掉是真省:那个开关节点的两个分支都是 lazy 的,关掉之后整条链根本不进执行计划。
- 笼统约束无效。换材质时背景和机位会跟着变,必须逐条点名——详见上面那张表。
局限与边界
把「不适合做什么」说清楚,比继续讲参数有用。以下是官方声明的局限,原样转述:
- 复杂编辑仍弱于 40 步基座。多参考图合成、换脸、证件类编辑可能产生重影或复制的人物;「保持一切不变」的请求可能漂移身份。
- 小字与长文本比 40 步基座更容易糊。
- 2K 输出未与教师模型对验。
- 未测试:RGBA 输出、超过 3 张参考图、基于 mask 的局部编辑。
- 官方标注的指标是自测的 96 / 32 条 held-out 请求,不声称任何标准 benchmark。
| 不要写 | 为什么 | 应该怎么写 |
|---|---|---|
| 「和 40 步基座同等质量」 | 官方明确说复杂编辑仍不如基座 | 「文生图接近基座,复杂编辑仍有差距」 |
| 「白拿 3.4 倍提速」 | 同条件 A/B:挂 LoRA 单跑 31.4 秒对摘掉 21.4 秒;非采样开销约 9.8 秒不随步数缩 | 见上文三个「但是」 |
| 「长文本中文渲染也没问题」 | 官方说小字 / 长文本比 40 步更容易糊 | 「本次 13 处短中文字串零错字」 |
| 「6 步是妥协」 | 官方测得 6 步构图漂移 0%,4 / 5 步各有 4% | 「6 步是这份 LoRA 的甜点」 |
| 「这批图可以直接商用」 | 加速权重是非商用许可 | 见下方许可说明 |
这套流程里可复用的三件事
- 把批量出图写成管线,不要靠手点。文生图与图像编辑各有一个批量脚本,前者改一个任务字典就能重跑,后者加任务就能扩展。图形界面的价值在于试参数,出成品应该交给脚本。
- 用「单进程驱动器」串起全流程。把一个前台进程设计成「启服务 → 轮询 → 收图 → 关服务」,彻底消灭「服务被外部终止、日志无堆栈」这类问题。
- 给编辑任务留一份可复读的提示词清单。编辑的成败几乎全在约束的写法上,把有效的写法存下来,比记住某个随机种子有用得多。
参数速查
| 项目 | 本机实测值 |
|---|---|
| 显存约束 | 8 GB(RTX 5060 Laptop) |
| 采样步数 | 6 步 |
| sigma 调度 | 1.0, 0.9375, 0.875, 0.75, 0.5, 0.25 |
| CFG | 关闭(走 BasicGuider,无负向提示词) |
| 采样器 | euler |
| LoRA 强度 | 1.0(alpha = rank,官方要求保持 1.0) |
| 提示词增强器 | 关闭(提示词全部人工撰写) |
| 画布 · 方图 | 1024 × 1024 |
| 画布 · 竖图 | 896 × 1216 |
| 编辑参考图 | 1 张(官方支持 1–3 张) |
| 编辑 resolution | 1024(方图源)/ 1056(竖图源) |
| 典型耗时 | 文生图 18.2 s / 编辑 43.4 s |
官方尺寸表里「1024² 面积 / 3:4」是 896×1184。本项目用的是 896×1216,比标准 3:4 略瘦长(面积大 2.7%)。官方说其它尺寸也能用、效果正常;但如果你要严格对齐官方推荐尺寸,应该改成 896×1184。
这套加速 LoRA 的授权是 Qwen RESEARCH LICENSE AGREEMENT——仅限非商业用途(研究或评估)。商业使用需要单独授权,并按 NOTICE 要求署名。它是 Qwen-Image 2.1 的衍生作品。
本页所有图片均为 AI 生成,使用非商用许可的加速权重在本地生成,仅作技术演示;Qwen-Image 2.1 基座本身的授权条款以 Qwen 官方发布为准。
官方规格、sigma 调度的设计理由、LoRA 的蒸馏方式与已知局限,来自官方的模型与加速 LoRA 说明文档;显存、版本号、权重体积、逐张耗时、失败记录与踩坑,全部来自我这台机器的实测。8 GB 档的参数是在官方配置基础上做的降档适配,换显存档位时建议重新核一遍。
工作流拆解
文生图:自定义 sigma(6 步)→ 无 CFG(BasicGuider)→ euler 采样 → VAE 解码
图像编辑:官方 edit 拓扑 → 参考图编码(resolution = 参考图目标面积,恰好回到源尺寸)→ 同参数 6 步 → 输出与源图逐像素同尺寸
加速:Viggle Turbo LoRA r128 运行时挂载,强度 1.0,不合并进模型
批量:文生图 / 编辑各一条脚本管线,配「启服务 → 出图 → 收工」单进程驱动器
参数表
- 显存约束
- 8GB(RTX 5060 Laptop)
- 采样步数
- 6
- sigma 调度
- 1.0, 0.9375, 0.875, 0.75, 0.5, 0.25
- CFG
- 关闭(BasicGuider,无负向提示词)
- 采样器
- euler
- LoRA 强度
- 1.0
- 画布
- 1024x1024(方图)/ 896x1216(竖图)
- 编辑 resolution
- 1024(方图源)/ 1056(竖图源)
- 典型耗时
- 文生图 18.2s / 编辑 43.4s
- 启动参数
- --lowvram --fp8_e4m3fn-unet --use-sage-attention --enable-manager