MiniMax-H3 本地部署笔记:8 GB 显存跑通音视频联合生成
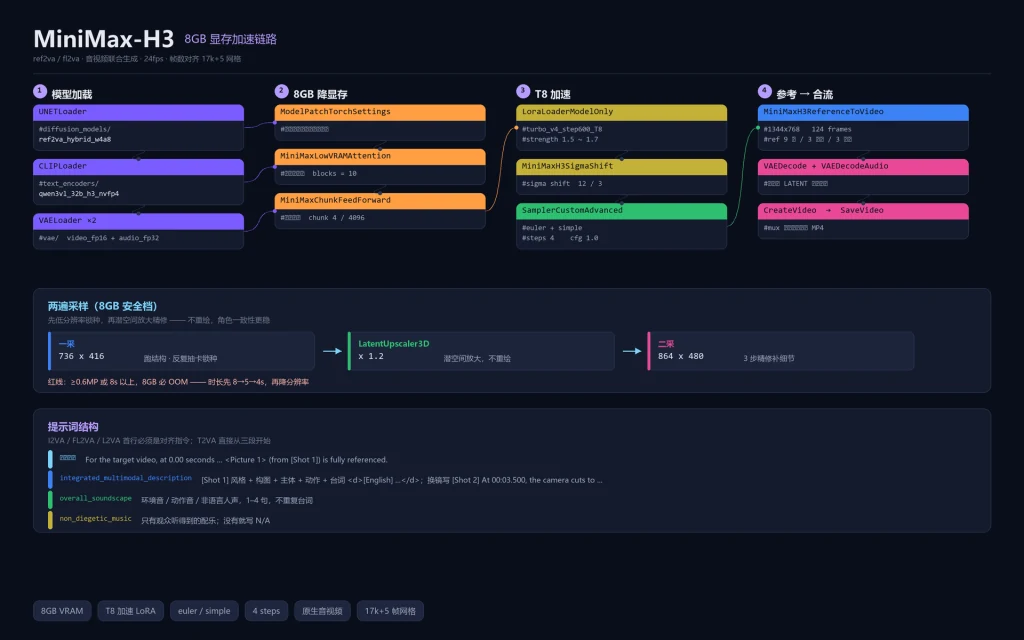
一句话结论:MiniMax-H3 是我跑过的模型里最不像「本地能跑」的一个——一套权重加起来约 51.7 GB,而我这台笔记本只有 8 GB 显存。它能跑通,靠的不是显卡,而是节点级降显存、4 步加速 LoRA、潜空间两遍采样这三件事叠在一起。这篇把这条链路完整拆开。
先说清楚 H3 是什么
它不是普通的文生视频模型。官方定义是通用全模态生成模型:同时理解文本、图像、视频、音频,并在一次前向里联合生成视频与立体声音频——人声、音效、背景音乐是一起建模出来的,不是先出无声画面再后期配音。
规格上:输出最高 2K、24fps、最长约 15 秒。原生画布短边固定 768px,上限 768×1344,宽高必须补齐 32 的倍数。
时长不能随手填。工作流里有一个数学表达式节点负责把「秒数」换算成合法帧数,强制对齐到 17k+5 的帧网格(24fps 下)。所以 5 秒不是 120 帧,而是 124 帧。自己算很容易对不齐,交给节点算最省事。
硬件与版本前提
下面这些是这台机器的实测值,不是抄来的推荐配置。
| 项目 | 实际值 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Laptop |
| 显存 | 8151 MB(ComfyUI 报 8150 MB,运行时置 LOW_VRAM) |
| 内存 | 16087 MB |
| PyTorch | 2.9.1+cu130 |
| Python | 3.13.11 |
| ComfyUI 前端包 | 1.52.7 |
权重按精度分了两条线(int8 与 nvfp4)。磁盘上的实测体积如下——UNet 是单文件 30 GB 量级,动手之前先把盘留够。
| 文件 | 实测体积 |
|---|---|
minimax_h3_fl2va_int8_convrot.safetensors |
32,462.0 MB |
minimax_h3_ref2va_int8_convrot.safetensors |
32,462.0 MB |
qwen3vl_32b_minimax_h3_nvfp4_awq.safetensors |
14,960.4 MB |
minimax_h3_video_vae_fp16.safetensors |
4,966.6 MB |
minimax_h3_video_vae_int8_convrot.safetensors |
3,024.7 MB |
minimax_h3_audio_vae_fp32.safetensors |
577.2 MB |
minimax_h3_turbo_v4_step600_comfyui_T8-convert.safetensors(加速 LoRA) |
743.7 MB |
minimax_h3_fl2v_turbo_4step_v1.2_768p_comfyui_bf16.safetensors |
1,865.6 MB |
minimax_h3_ref2v_turbo_8step_v1.0_768p_comfyui_bf16.safetensors |
1,865.6 MB |
fl2va 与 ref2va 是两套不同的权重,不是同一个模型的两个名字。一套「UNet + 文本编码器 + 视频 VAE + 音频 VAE」的可用组合约 51.7 GB,而两种任务类型各需要各自的 UNet。按任务选,别一股脑全下。
四种任务类型,别当成一个模型用
| 类型 | 含义 |
|---|---|
| T2VA | 纯文本构建完整的视听时间线 |
| I2VA | T2VA 主体 + 首帧指令,画面从首帧向前发展 |
| FL2VA | T2VA 主体 + 首尾帧指令,描述首帧到尾帧之间的连续路径 |
| L2VA | T2VA 主体 + 尾帧指令,从合理的「前一状态」收敛到最后一帧 |
四种任务共用同一套提示词骨架,区别只在首行指令与视觉路径的描述方式。这也是为什么一份提示词规范能同时覆盖四个任务。
工作流拆解
按数据流分四段。
① 模型加载
三段加载器:UNet(扩散权重本体)、CLIP 文本编码器(Qwen3-VL 32B 的量化版)、两个 VAE。音频 VAE 之所以单独占一个加载器,是因为音视频是两条独立的解码路径——视频走 fp16 或 int8,音频走 fp32。
② 8GB 降显存
真正让 8 GB 跑通的是这三个节点:
ModelPatchTorchSettings—— 让权重按显存上限分批搬运,而不是一次全塞进去MiniMaxLowVRAMAttention(blocks 10)—— 注意力分块,把峰值显存摊平MiniMaxChunkFeedForward(chunk 4 / 4096)—— 前馈层分块计算
它们不改变结果,只改变计算顺序——代价是速度,换来的是「能跑完」。
③ T8 加速
降显存解决的是能不能跑,加速解决的是能不能忍。这一段的组合是:加速 LoRA(turbo_v4_step600 的 T8 转换版,强度 1.5~1.7)→ sigma shift(12 / 3)→ 采样器(euler + simple,4 步)。
关键经验是加速方案必须成组用:只换采样器收益有限,LoRA 与调度参数要一起配,才把步数压到 4 步。
④ 参考 → 合流
参考生视频节点吃三类输入,上限是 9 张参考图、3 段参考视频(每段可带自己的配对音轨)、3 段独立参考音频。参考图尺寸有两个档:match 会把参考缩到生成分辨率,更快;max 最多保留 2048px 短边,身份还原更准,但参考 token 会参与每一步采样,速度明显下降。8 GB 档下建议保持 match。
采样器输出的联合 LATENT 会同时喂给视频解码与音频解码两个节点——各自从打包好的 latent 里取自己那一半,最后 CreateVideo 把两条流 mux 成一个带声音的 MP4。
提示词结构
H3 的提示词不是一段自由描述,而是有固定骨架的。I2VA / FL2VA / L2VA 的首行必须是对齐指令,后面空一行,再写三段核心字段。
For the target video, at 0.00 seconds into the target video, <Picture 1> (from [Shot 1]) is fully referenced.

integrated_multimodal_description: [Shot 1] 2D-animated, ...

overall_soundscape: ...

non_diegetic_music: ...
三段各自管什么:
integrated_multimodal_description—— 主描述。按时间线写画面、动作、镜头、说话人、台词与同期声。换镜写[Shot 2] At 00:03.500, the camera cuts to ...,第一镜不加时间戳。overall_soundscape—— 环境音、动作音、非语言人声,1–4 句。台词已经写在主描述里,这里不重复。non_diegetic_music—— 只有观众能听到的配乐,1–3 句。只写配器、速度、节奏与动态,不写抽象情绪词。没有就写N/A。
还有两处细节容易写错:
- 台词。说话人用
(S1)(S2)这样的稳定 ID,跨镜头保持一致;台词本身放在 <d> 里,只写语言标签与原话,原样保留、不翻译不改写:<d>[English] I get off at the next station.</d> - 镜头运动。要写成自然的英语动作句,而不是在句尾堆标签。表达式由三个维度组成:运动类型 + 幅度 + 速度。例:
The camera pushes in with small amplitude at slow speed toward the folded letter in her hands.幅度与速度不关键时可以省略。
参考标签要精确匹配连线顺序,并明确说明哪个参考驱动镜头的哪一部分。含糊其辞会让参考图「乱入」到不该出现的地方。
两遍采样:8GB 档的画质解法
直接上高分辨率会 OOM。可行的做法是把一次生成拆成两遍:第一遍用低分辨率把结构和运动跑出来,然后用潜空间放大器(LatentUpscaler3D,倍率 1.2)放大 latent,第二遍只走 3 步做细节精修。
| 阶段 | 参数 |
|---|---|
| 第一遍 | 0.3 MP → 736×416,跑结构与运动 |
| 放大 | 潜空间放大 ×1.2,不重绘,因此角色一致性不会被破坏 |
| 第二遍 | target 0.4 MP → 864×480,只走 3 步精修 |
| 时长 | 5 秒 ≈ 124 帧 @24fps |
第二遍与第一遍之间,模型、提示词、参考图、随机种子都不能改(LoRA 除外)。最终音频要接第一遍的音频解码,不要接第二遍。改了任何一项,你手里拿到的就是另一张卡——前面的抽卡等于白抽。
还有一条很值得抄的设计:把流程拆成「一采预览」与「二采成片」两个执行模式。预览模式用随机种子反复抽卡,节点会显示本次真正提交给后端的种子;抽到满意的一键固定,再切到成片模式。这样不用靠手抄随机数,也不会因为记错种子而重来。
踩坑记录
- 加速补丁会在升级后失效。加速体系依赖对模型文件打补丁,ComfyUI 大版本升级后补丁可能被覆盖,表现是「加速节点照跑但没效果」。重新执行一次补丁脚本即可,不用重装。
- 画面紊乱或出现乱码,先把块缓存关掉。块缓存是拿速度换稳定性的,参数越激进越容易出问题。处理顺序:把缓存深度从 0.75 降到 0.5、再降到 0(0 = 全完整步,最稳),或者直接关闭连续缓存。
- 鬼影或过曝,是 CFG 的问题。加速 LoRA 配高 CFG 会过冲,把 CFG 降到 1.0 通常就能解决。
- OOM 的处理顺序要固定。先降时长(8 → 5 → 4 秒),再降第一遍分辨率(0.3 → 0.2 MP),最后降第二遍目标分辨率(0.5 → 0.4 → 0.3 MP)。参考图的尺寸档保持
match,不要为了省显存去动它。 - 8 GB 的硬红线。第二遍目标 ≥0.6 MP,或时长 ≥8 秒——必 OOM,不用试。0.5 MP(960×544)只在时长 ≤5 秒、且跑之前清空显存的前提下可以尝试。
参数速查
| 项目 | 8GB 档实测值 |
|---|---|
| 显存约束 | 8 GB(RTX 5060 Laptop) |
| 第一遍分辨率 | 0.3 MP → 736×416 |
| 第二遍分辨率 | 0.4 MP → 864×480 |
| 时长 | 5 秒 = 124 帧 @24fps(对齐 17k+5) |
| 采样器 / 调度器 | euler + simple |
| 步数 / CFG | 4 步 / 1.0 |
| 加速 LoRA | turbo_v4_step600_T8,强度 1.5~1.7 |
| Sigma shift | 12 / 3 |
| 参考图尺寸档 | match |
这套流程的边界
把「不适合做什么」说清楚,比继续讲参数有用:
- 人脸修复节点不是锐化器。它修的是眼、口、鼻、脸型这类结构畸变,以及轻微的跨帧跳动。如果原片本身失焦、低清,或已经被放大得很糊,它会延续那种模糊质感,不会自动变清晰。要清晰化,得先在它之外做受控超分。
- 多镜头长视频不是一次生成出来的。约 15 秒是单次生成的上限。我做过的多镜头链路,实际是把多段帧数对齐的片段分别生成、各自处理音频,最后再拼接。镜头之间的连贯性要靠提示词与参考帧自己保证——模型不会替你记着上一镜的构图。
- 8 GB 是降档运行,不是等效替代。所有参数都在「能跑完」这一侧做了让步,画质上限受此约束。想上 1.0 MP 以上,换卡比调参有效。
模型规格、任务类型与提示词结构来自 MiniMax H3 官方说明与 ComfyUI 官方工作流模板;显存、版本号、模型体积与踩坑记录来自我这台机器的实测。8 GB 档的参数是在社区方案基础上做的降档适配,换显存档位时建议重新核一遍。
工作流拆解
降显存:ModelPatchTorchSettings → MiniMaxLowVRAMAttention(10) → MiniMaxChunkFeedForward(4 / 4096)
加速:turbo_v4 T8 LoRA(1.5~1.7) → SigmaShift(12 / 3) → euler + simple,4 步
出片:ReferenceToVideo(9 图 / 3 视频 / 3 音频) → 视频与音频双路解码 → CreateVideo mux 成 MP4
画质:一采 736x416 跑结构 → 潜空间放大 x1.2 → 二采 864x480 精修 3 步
参数表
- 显存约束
- 8GB(RTX 5060 Laptop)
- 分辨率
- 一采 0.3MP=736x416 → 二采 0.4MP=864x480
- 时长
- 5 秒 = 124 帧 @24fps(对齐 17k+5 网格)
- 采样器
- euler + simple,4 步,CFG 1.0
- 加速 LoRA
- turbo_v4_step600_T8,强度 1.5~1.7
- Sigma shift
- 12 / 3
- 参考图尺寸
- match
- 红线
- ≥0.6MP 或时长 ≥8 秒,8GB 必 OOM